
Plusieurs agents Claude Code en parallèle : ce qui marche, ce qui casse

Pour faire travailler plusieurs agents Claude Code en même temps, donnez à chacun son git worktree et sa branche. Au-delà de trois ou quatre agents, les vrais problèmes sont les conflits de fichiers, la relecture et le coût : il faut un ticket par agent, un périmètre de fichiers et une relecture avant fusion.
Pourquoi paralléliser, et ce qui casse dès le deuxième agent
Une équipe de développement humaine ne travaille presque jamais à un seul ingénieur à la fois sur un projet actif : plusieurs personnes avancent en parallèle sur des parties différentes du même dépôt, avec un système de branches, de relecture et d'intégration déjà rodé pour cela depuis des années. La même logique s'applique à des agents Claude Code : rien n'empêche, en principe, de faire avancer plusieurs agents sur le même projet en même temps, du moment que chacun reste dans son propre périmètre, de la même manière qu'on attendrait d'un ingénieur humain qu'il ne touche pas au module d'un collègue sans coordination préalable.
Faire travailler un seul agent Claude Code à la fois a une limite simple : le temps total reste la somme du temps de chaque tâche, même quand plusieurs tâches n'ont strictement rien en commun. Traduire un article dans six langues, corriger un bug côté serveur pendant qu'on étoffe une page de documentation, ou avancer trois tickets indépendants d'une même fiche de travail sont des cas où rien n'oblige à attendre qu'un agent termine avant de lancer le suivant. Paralléliser plusieurs agents Claude Code, que ce soit par des sous-agents dans une même session, par des équipes d'agents coordonnées, ou par des sessions indépendantes dans des worktrees séparés, promet de ramener ce temps total au temps de la tâche la plus longue plutôt qu'à la somme de toutes les tâches.
Le lancement de plusieurs agents en parallèle n'est presque jamais le problème : n'importe quel terminal peut ouvrir plusieurs sessions Claude Code en quelques secondes. Les problèmes commencent dès que deux agents touchent, même brièvement, un état partagé, qu'il s'agisse d'un fichier, d'une branche, d'un port de serveur local ou d'un budget de relecture déjà occupé ailleurs. Quatre symptômes reviennent, à peu près dans cet ordre d'apparition à mesure que le nombre d'agents augmente.
Le premier symptôme est le conflit de fichiers : deux agents qui modifient le même fichier en même temps, dans le même répertoire de travail, finissent presque toujours par écraser une partie du travail l'un de l'autre, surtout quand aucun des deux ne relit l'état le plus récent avant de committer. Le risque grandit encore quand les deux agents partagent le même répertoire de travail Git, ce qui signifie que chacun voit, au même instant, les modifications non commitées de l'autre, bien avant que l'un ou l'autre n'ait pu les valider.
Le deuxième symptôme est le contexte perdu : un agent qui reprend une tâche après qu'un autre agent a modifié un fichier voisin travaille parfois sur une version du code qui n'existe déjà plus, parce que son propre contexte de conversation n'a jamais été informé du changement. Ce décalage ne produit pas toujours une erreur visible tout de suite ; il produit souvent un code qui compile, qui semble correct localement, mais qui contredit une décision prise entretemps par un agent voisin sur le même fichier ou sur un fichier qui en dépend.
Le troisième symptôme est la relecture qui sature : chaque agent supplémentaire produit un diff supplémentaire à relire, et la relecture ne se parallélise pas aussi facilement que l'écriture, parce qu'elle demande une attention humaine ou une relecture automatisée dont la capacité reste, elle, à peu près fixe. Selon une étude de CodeRabbit relayée par The Register en décembre 2025, les pull requests co-écrites par l'IA contiennent 1,7 fois plus de problèmes que les pull requests écrites sans assistance : multiplier les agents sans multiplier la capacité de relecture revient à accumuler une dette qui ne se voit qu'au moment de l'intégration.
Le quatrième symptôme est le coût, qui grimpe plus vite que le nombre d'agents plutôt qu'au même rythme : chaque agent reconstruit une partie de son propre contexte à chaque session, chaque conflit résolu après coup consomme à nouveau des tokens pour relire et corriger, et une coordination mal cadrée entre agents ajoute des allers-retours qui n'existeraient pas avec un seul agent. La documentation de Claude Code sur la gestion des coûts recommande, pour cette raison précise, de cadrer le périmètre de chaque session avant de la lancer plutôt que de la laisser grandir au fil de la conversation.
Ces quatre symptômes ne sont pas des arguments contre la parallélisation elle-même : ils indiquent simplement qu'au-delà d'un agent, le travail de coordination ne disparaît pas, il se déplace de l'écriture du code vers la définition du périmètre, des critères et de la relecture. La section suivante détaille, étape par étape, comment poser ce cadre avant de lancer le deuxième agent plutôt qu'après avoir constaté le premier conflit.
Méthode pas à pas pour garder le contrôle
Cinq pratiques couvrent la plus grande partie des symptômes décrits plus haut. Aucune ne dépend d'un outil en particulier : elles s'appliquent aussi bien à des sous-agents dans une même session qu'à des sessions indépendantes lancées dans des worktrees séparés. Elles se posent dans cet ordre, parce que chacune réduit un risque que la suivante ne peut plus entièrement rattraper une fois qu'il s'est produit.
La première pratique est un worktree Git et une branche par agent. La commande git worktree add crée un répertoire de travail séparé, avec son propre état de fichiers, tout en partageant le même historique Git que le dépôt principal : deux agents installés dans deux worktrees différents ne peuvent plus, par construction, voir ni écraser les fichiers non commités l'un de l'autre, même s'ils travaillent au même instant sur le même dépôt. La documentation de Claude Code sur les flux de travail courants décrit précisément ce schéma pour faire tourner plusieurs sessions en parallèle sans qu'elles ne se marchent dessus, chaque session restant sur sa propre branche jusqu'à ce qu'une fusion explicite rapproche le travail des autres. Un agent qui termine sa tâche laisse derrière lui une branche prête à relire, que l'intégration retienne ou rejette sans jamais avoir touché au répertoire de travail des agents encore en cours.
La deuxième pratique est un périmètre de fichiers défini par tâche, avant que l'agent ne commence à écrire. Un ticket qui précise exactement quels fichiers ou quels dossiers un agent peut modifier retire une bonne partie du risque de conflit avant même qu'il ne survienne, puisque deux agents dont les périmètres ne se recoupent pas ne peuvent, par définition, pas écrire sur le même fichier. Ce périmètre doit rester plus étroit que ce que la fiche de poste de l'agent autoriserait en général, parce que c'est le ticket en cours, pas le rôle de l'agent, qui détermine ce dont une tâche précise a réellement besoin. Un périmètre trop large, même avec de bonnes intentions, revient à redonner aux agents la même exposition qu'un seul agent sans aucun découpage, seulement répartie entre plusieurs sessions plutôt que concentrée dans une seule.
La troisième pratique est d'écrire les critères d'acceptation avant de lancer l'agent, pas après avoir lu sa livraison. Un critère écrit à l'avance, du type « la commande de build passe » ou « les cinq traductions reprennent les mêmes sections », donne à l'agent une cible vérifiable et donne à son relecteur un test objectif plutôt qu'une impression générale sur la qualité du résultat. Sans critère préalable, la relecture dérive vers une appréciation au cas par cas, qui devient vite incohérente d'un agent à l'autre et d'une tâche à l'autre. Ce même critère sert aussi de point d'arrêt : un agent qui n'arrive pas à le satisfaire signale un blocage avant la relecture, plutôt que de livrer un résultat approximatif en espérant qu'il passe inaperçu.
La quatrième pratique est une relecture avant toute intégration, jamais après. Un diff relu avant la fusion peut encore être corrigé sans affecter le travail des autres agents ; un diff fusionné d'abord et relu ensuite oblige à défaire un historique déjà partagé, avec le risque de retirer, par la même occasion, un travail valide fait entretemps par un agent voisin sur un fichier qui en dépend. La relecture doit porter sur le diff réel, pas seulement sur le résumé que l'agent fournit de son propre travail, précisément parce qu'un résumé optimiste ne révèle pas toujours un critère d'acceptation resté non satisfait. Cette discipline coûte un peu de temps à chaque livraison, mais elle coûte toujours moins que de démêler, après une fusion, lequel des deux agents a produit quelle partie d'un même fichier.
La cinquième pratique est de limiter le nombre de sessions simultanées à ce que la relecture peut réellement absorber. La documentation de Claude Code sur les sous-agents et les équipes d'agents recommande de commencer avec trois à cinq coéquipiers avant d'envisager d'aller plus loin, en rappelant que deux agents sur le même fichier produisent presque toujours un écrasement plutôt qu'une fusion propre. Ce chiffre n'est pas une limite technique du protocole ; c'est une limite pratique de ce qu'un relecteur, humain ou automatisé, peut vérifier sérieusement avant d'intégrer. Augmenter ce nombre reste possible plus tard, une fois que le périmètre de fichiers, les critères d'acceptation et la relecture avant fusion sont déjà rodés sur un petit nombre d'agents.
Tableau des pièges et parades
Le tableau suivant reprend les pièges les plus fréquents observés au-delà de deux agents, avec leur symptôme concret et la parade qui l'évite ; chaque parade renvoie directement à l'une des cinq pratiques de la section précédente.
| Piège | Symptôme | Parade |
|---|---|---|
| Deux agents sur le même fichier | Écrasement d'une partie du travail avant commit ou à la fusion | Un worktree et une branche par agent |
| Périmètre de tâche flou | Deux agents modifient des fichiers qui se recoupent sans le savoir | Un périmètre de fichiers écrit dans le ticket avant le lancement |
| Critère d'acceptation absent | La livraison semble terminée mais ne répond pas à la vraie demande | Des critères d'acceptation écrits avant le lancement de l'agent |
| Fusion avant relecture | Un défaut découvert après coup oblige à défaire un historique partagé | Une relecture du diff réel avant toute intégration |
| Trop de sessions en même temps | La relecture sature et la dette de code s'accumule sans être vue | Un nombre de sessions simultanées limité à ce que la relecture absorbe |
| Contexte non partagé entre agents | Un agent travaille sur une version du code déjà changée par un autre | Un ticket par agent avec son propre périmètre, relu avant fusion |
Comment Atipol s'y prend
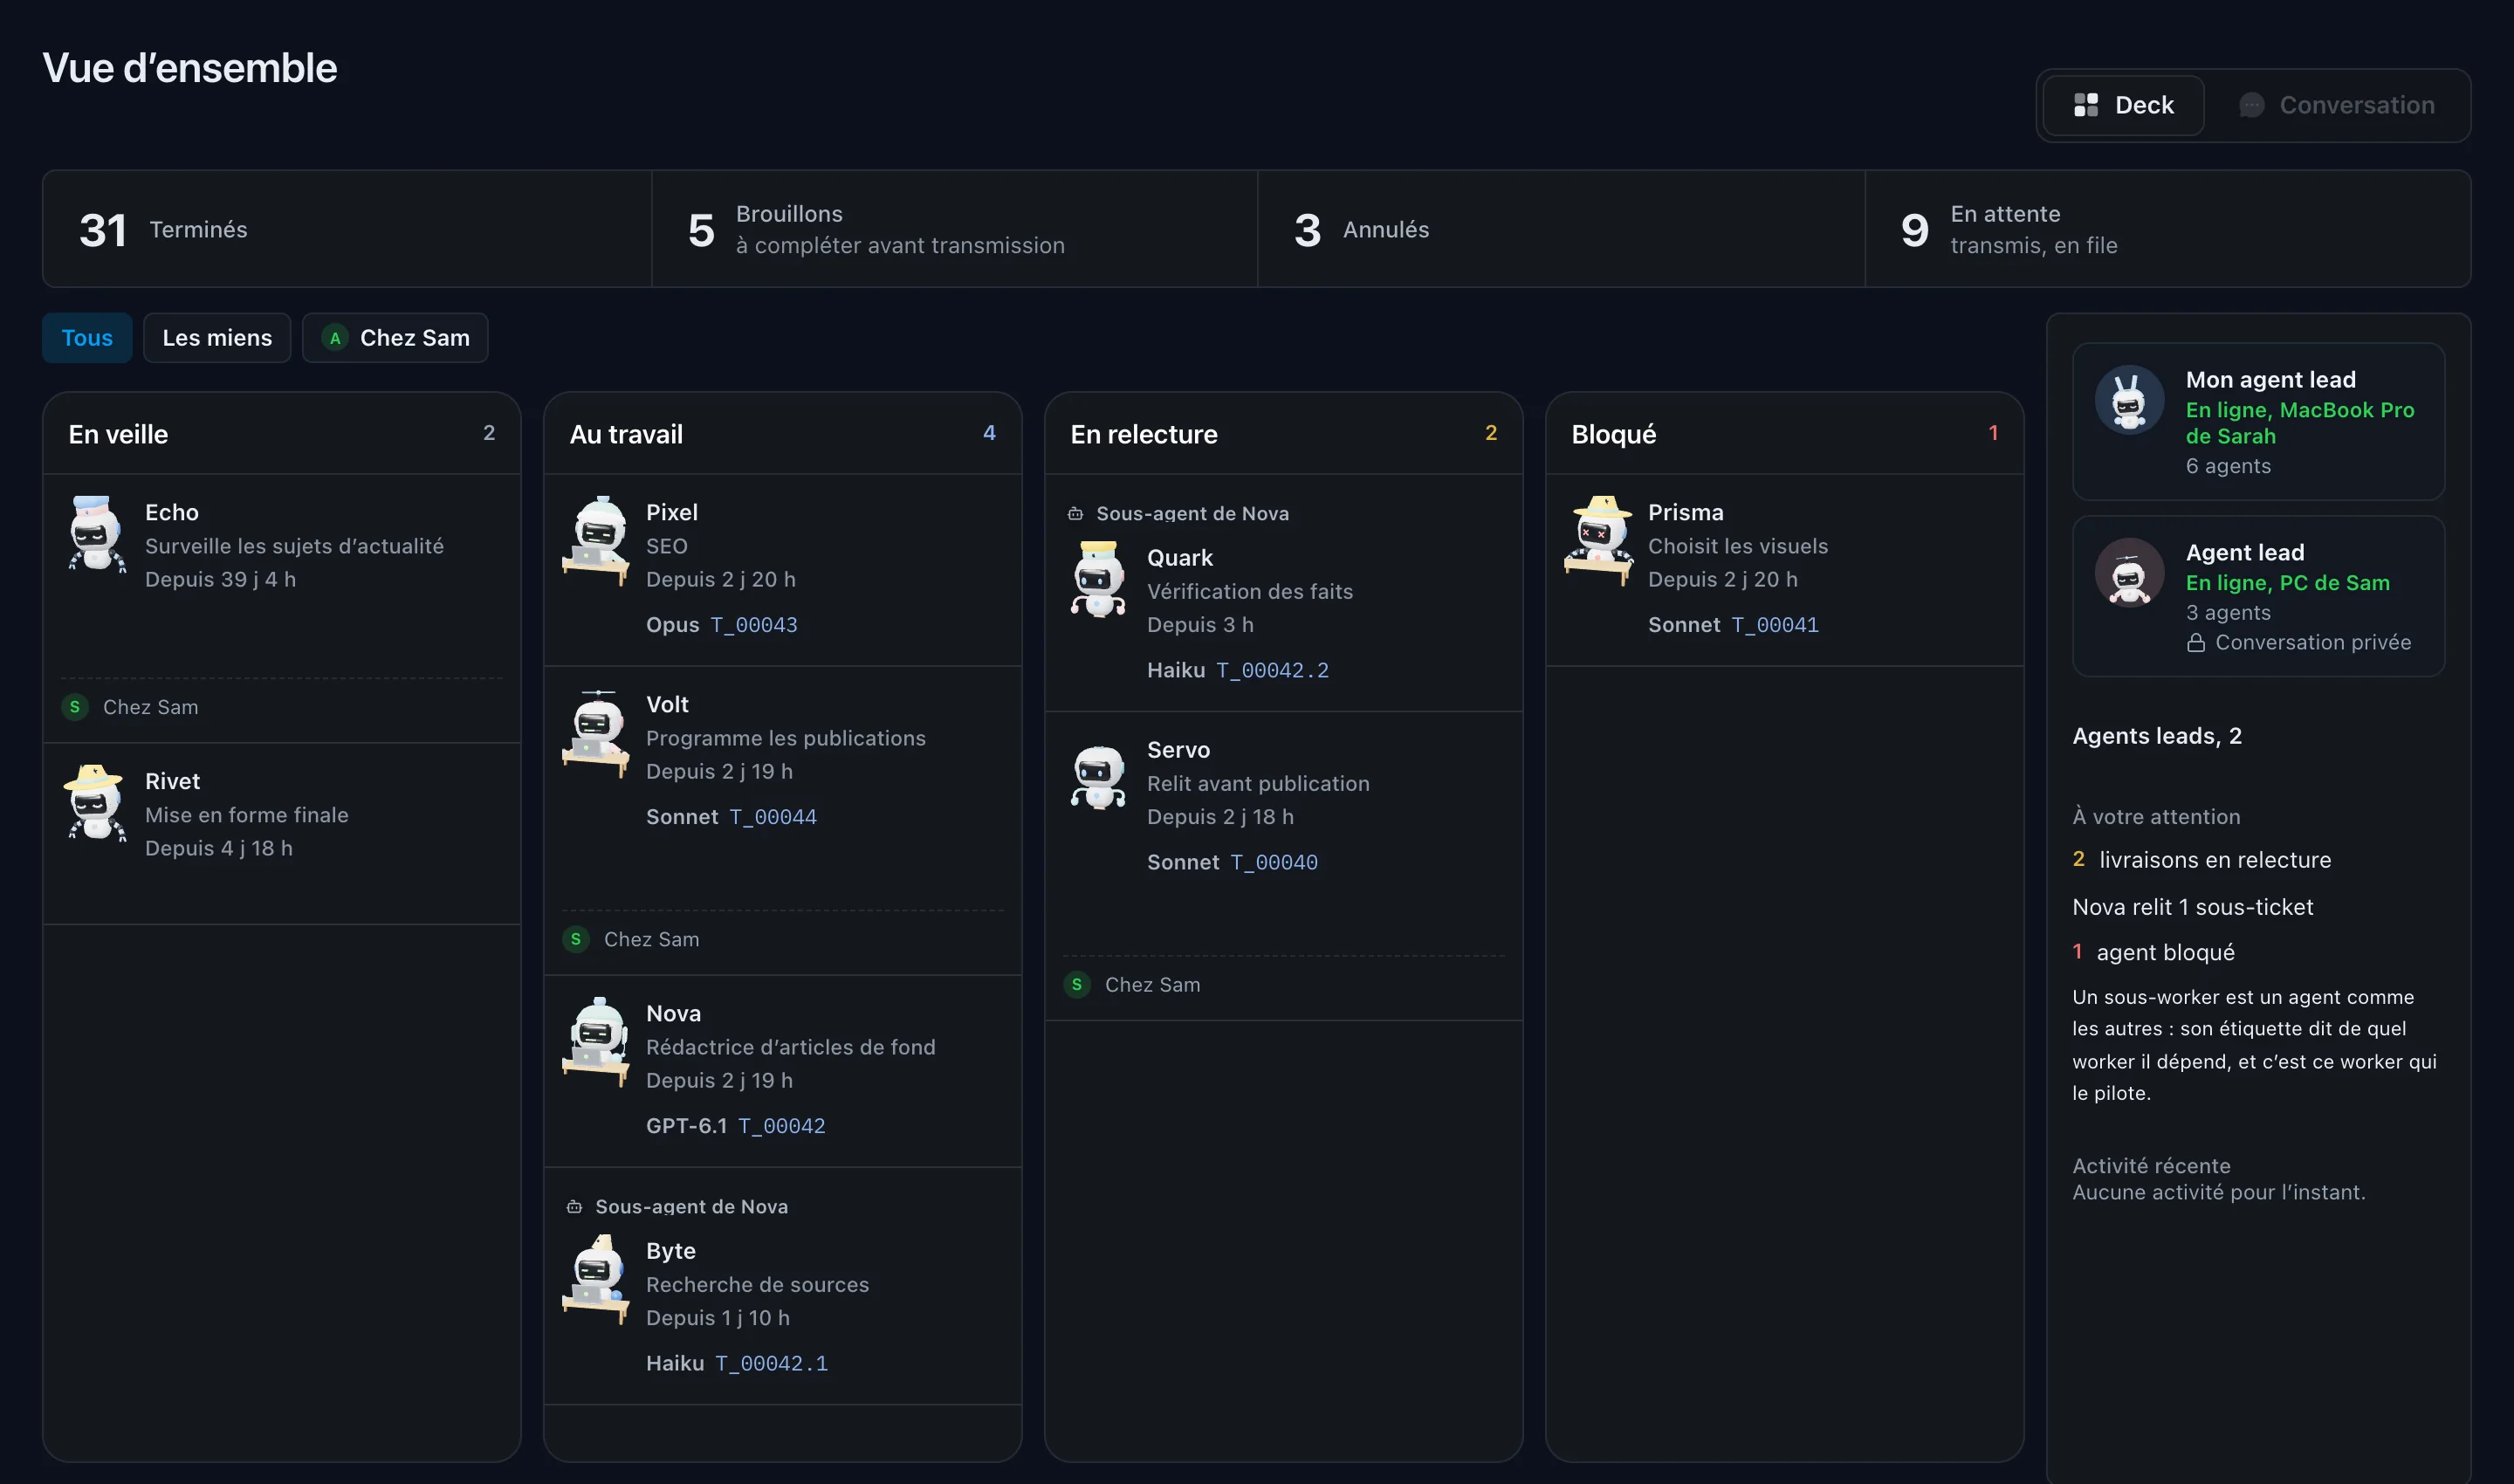
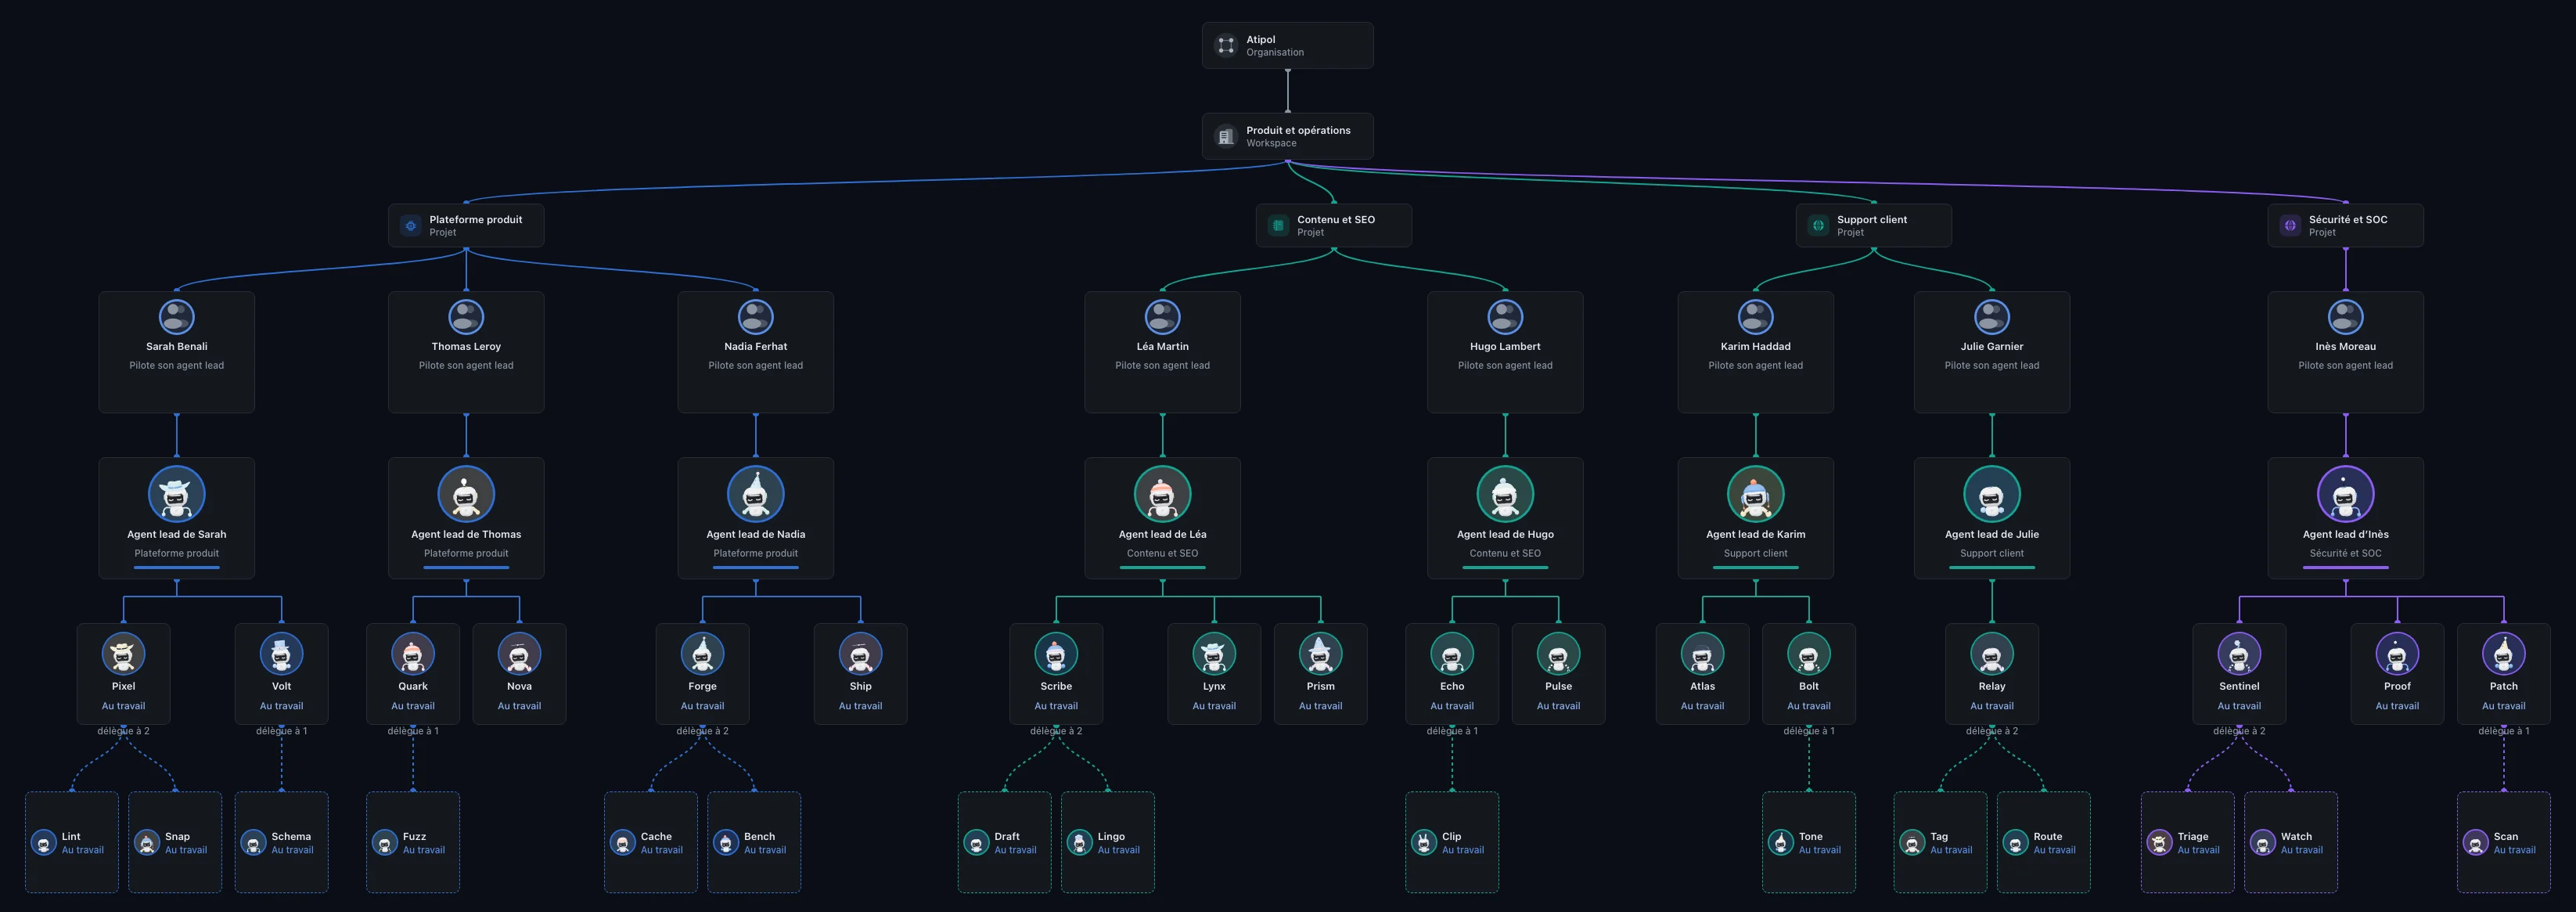
Dans Atipol, chaque agent travaille dans son propre worktree Git, sur sa propre branche : deux agents ne modifient jamais les mêmes fichiers au même instant, par construction plutôt que par discipline individuelle. Chaque ticket réserve un périmètre de fichiers avant que l'agent ne commence à écrire, et deux tickets en cours ne peuvent pas réserver le même périmètre : le risque d'écrasement entre deux agents est retiré avant le premier commit plutôt qu'au moment de la fusion. Cette réservation se vérifie au moment même où le ticket est transmis à un agent, pas a posteriori lors d'une revue de fin de semaine, ce qui évite qu'un chevauchement ne soit découvert seulement après que les deux agents ont déjà écrit sur les mêmes lignes.
Chaque ticket exige des critères d'acceptation écrits avant le lancement de l'agent, ce qui évite qu'une tâche se termine sans qu'on sache précisément ce qui devait être vrai pour la considérer faite. L'agent lead du projet relit chaque livraison avant de l'intégrer, et cette intégration rejoue les contrôles du projet plutôt que de faire confiance à la seule relecture qui l'a précédée. Cette relecture porte sur le diff réel produit par l'agent, et l'intégration qui suit ne se contente pas de l'avis du relecteur : elle rejoue elle-même les contrôles du projet, pour qu'un oubli dans la revue ne devienne pas un défaut silencieux dans la branche principale.
Le nombre de sessions simultanées se règle au niveau du projet, pour que la charge de relecture et le coût en tokens restent sous le contrôle de l'équipe plutôt que de croître avec le seul nombre d'agents qu'on pourrait lancer. Ce réglage reste entre les mains de l'équipe qui porte le projet, pas un paramètre fixé une fois pour toutes par la plateforme elle-même. Atipol n'est pas limité à Claude Code : le même cadre de tickets, de périmètre de fichiers et de relecture avant intégration s'applique à d'autres agents de développement.
Questions fréquentes
Faut-il un worktree pour chaque agent Claude Code ?
Dès que deux agents touchent le même dépôt en même temps, oui : un worktree et une branche par agent retirent le risque de conflit de fichiers à la racine plutôt que de le gérer après coup.
Combien d'agents peut-on lancer en parallèle ?
Autant que de tâches réellement indépendantes. La limite concrète n'est pas le nombre de sessions qu'on peut ouvrir, mais la capacité de relecture et le budget disponibles pour les vérifier.
Que faire si deux agents doivent toucher le même fichier ?
Les enchaîner plutôt que les paralléliser sur ce fichier précis, ou découper la tâche pour que chaque agent reçoive un périmètre de fichiers distinct avant de commencer.
Un sous-agent remplace-t-il un worktree séparé ?
Non : un sous-agent reste dans la même session et le même contexte, pour une tâche annexe courte. Un worktree séparé sert au travail long et indépendant, sur sa propre branche.
Comment éviter que la relecture devienne le goulot d'étranglement ?
En limitant le nombre de sessions simultanées à ce qu'un relecteur peut vérifier sérieusement, et en écrivant les critères d'acceptation avant le lancement plutôt qu'après la livraison.
Comment Atipol empêche-t-il deux agents de réserver le même périmètre ?
Chaque ticket réserve un périmètre de fichiers avant que l'agent ne commence à écrire, et deux tickets en cours ne peuvent pas réserver le même périmètre : le conflit est écarté avant le premier commit.
Sources
- Claude Code, Common workflows (git worktrees)
- Claude Code, Subagents
- Git, git-worktree
- Claude Code, Manage costs
- The Register, CodeRabbit, 17/12/2025
Pour relier cette méthode à un cadre complet de gouvernance, consultez notre guide de gouvernance des agents IA.
Pour ce que ces agents en parallèle représentent en coût réel, consultez notre article sur le coût des agents IA.
La démo publique montre une organisation fictive en fonctionnement, sans compte. L'offre gratuite donne un projet, trois agents et un agent lead.