
Varios agentes de Claude Code en paralelo: lo que funciona y lo que falla

Para que varios agentes de Claude Code trabajen a la vez, dé a cada uno su git worktree y su rama. A partir de tres o cuatro agentes, los verdaderos problemas son los conflictos de archivos, la revisión y el coste: hace falta un ticket por agente, un alcance de archivos y una revisión antes de la fusión.
Por qué paralelizar, y qué se rompe a partir del segundo agente
Un equipo de desarrollo humano casi nunca trabaja con un solo ingeniero a la vez en un proyecto activo: varias personas avanzan en paralelo en partes distintas del mismo repositorio, con un sistema de ramas, revisión e integración ya rodado para eso desde hace años. La misma lógica se aplica a los agentes de Claude Code: en principio nada impide hacer avanzar a varios agentes en el mismo proyecto al mismo tiempo, siempre que cada uno se mantenga dentro de su propio alcance, del mismo modo que se esperaría de un ingeniero humano que no tocara el módulo de un compañero sin coordinación previa.
Hacer trabajar a un solo agente de Claude Code a la vez tiene un límite sencillo: el tiempo total sigue siendo la suma del tiempo de cada tarea, incluso cuando varias tareas no tienen absolutamente nada en común. Traducir un artículo a seis idiomas, corregir un error en el servidor mientras se amplía una página de documentación, o avanzar en tres tickets independientes de una misma ficha de trabajo son casos en los que nada obliga a esperar a que un agente termine antes de lanzar el siguiente. Paralelizar varios agentes de Claude Code, ya sea mediante subagentes en una misma sesión, mediante agent teams coordinados, o mediante sesiones independientes en worktrees separados, promete reducir ese tiempo total al tiempo de la tarea más larga en lugar de a la suma de todas las tareas.
Lanzar varios agentes en paralelo casi nunca es el problema: cualquier terminal puede abrir varias sesiones de Claude Code en cuestión de segundos. Los problemas empiezan en cuanto dos agentes tocan, aunque sea brevemente, un estado compartido, ya sea un archivo, una rama, un puerto de servidor local o un presupuesto de revisión ya ocupado en otra parte. Cuatro síntomas se repiten, más o menos en este orden de aparición a medida que aumenta el número de agentes.
El primer síntoma es el conflicto de archivos: dos agentes que modifican el mismo archivo al mismo tiempo, en el mismo directorio de trabajo, casi siempre acaban sobrescribiendo parte del trabajo del otro, sobre todo cuando ninguno de los dos relee el estado más reciente antes de hacer commit. El riesgo crece todavía más cuando los dos agentes comparten el mismo directorio de trabajo de Git, lo que significa que cada uno ve, en el mismo instante, los cambios no confirmados del otro, mucho antes de que ninguno de los dos haya podido validarlos.
El segundo síntoma es el contexto perdido: un agente que retoma una tarea después de que otro agente haya modificado un archivo vecino a veces trabaja sobre una versión del código que ya no existe, porque su propio contexto de conversación nunca fue informado del cambio. Este desfase no siempre produce un error visible de inmediato; a menudo produce un código que compila, que parece correcto en local, pero que contradice una decisión tomada mientras tanto por un agente vecino sobre el mismo archivo o sobre un archivo que depende de él.
El tercer síntoma es la revisión que se satura: cada agente adicional produce un diff adicional que revisar, y la revisión no se paraleliza con la misma facilidad que la escritura, porque exige una atención humana o una revisión automatizada cuya capacidad se mantiene, en cambio, más o menos fija. Según un estudio de CodeRabbit recogido por The Register en diciembre de 2025, las pull requests coescritas con IA contienen 1,7 veces más problemas que las pull requests escritas sin asistencia: multiplicar los agentes sin multiplicar la capacidad de revisión equivale a acumular una deuda que solo se ve en el momento de la integración.
El cuarto síntoma es el coste, que sube más rápido que el número de agentes en lugar de al mismo ritmo: cada agente reconstruye parte de su propio contexto en cada sesión, cada conflicto resuelto a posteriori vuelve a consumir tokens para releer y corregir, y una coordinación mal planteada entre agentes añade idas y vueltas que no existirían con un solo agente. La documentación de Claude Code sobre la gestión de costes recomienda, precisamente por esto, acotar el alcance de cada sesión antes de lanzarla en lugar de dejar que crezca a lo largo de la conversación.
Estos cuatro síntomas no son argumentos contra la paralelización en sí: simplemente indican que, a partir de un segundo agente, el trabajo de coordinación no desaparece, se desplaza de la escritura del código a la definición del alcance, los criterios y la revisión. La siguiente sección detalla, paso a paso, cómo establecer ese marco antes de lanzar el segundo agente en lugar de después de comprobar el primer conflicto.
Método paso a paso para mantener el control
Cinco prácticas cubren la mayor parte de los síntomas descritos más arriba. Ninguna depende de una herramienta en particular: se aplican tanto a subagentes dentro de una misma sesión como a sesiones independientes lanzadas en worktrees separados. Se aplican en este orden, porque cada una reduce un riesgo que la siguiente ya no puede remediar del todo una vez que se ha producido.
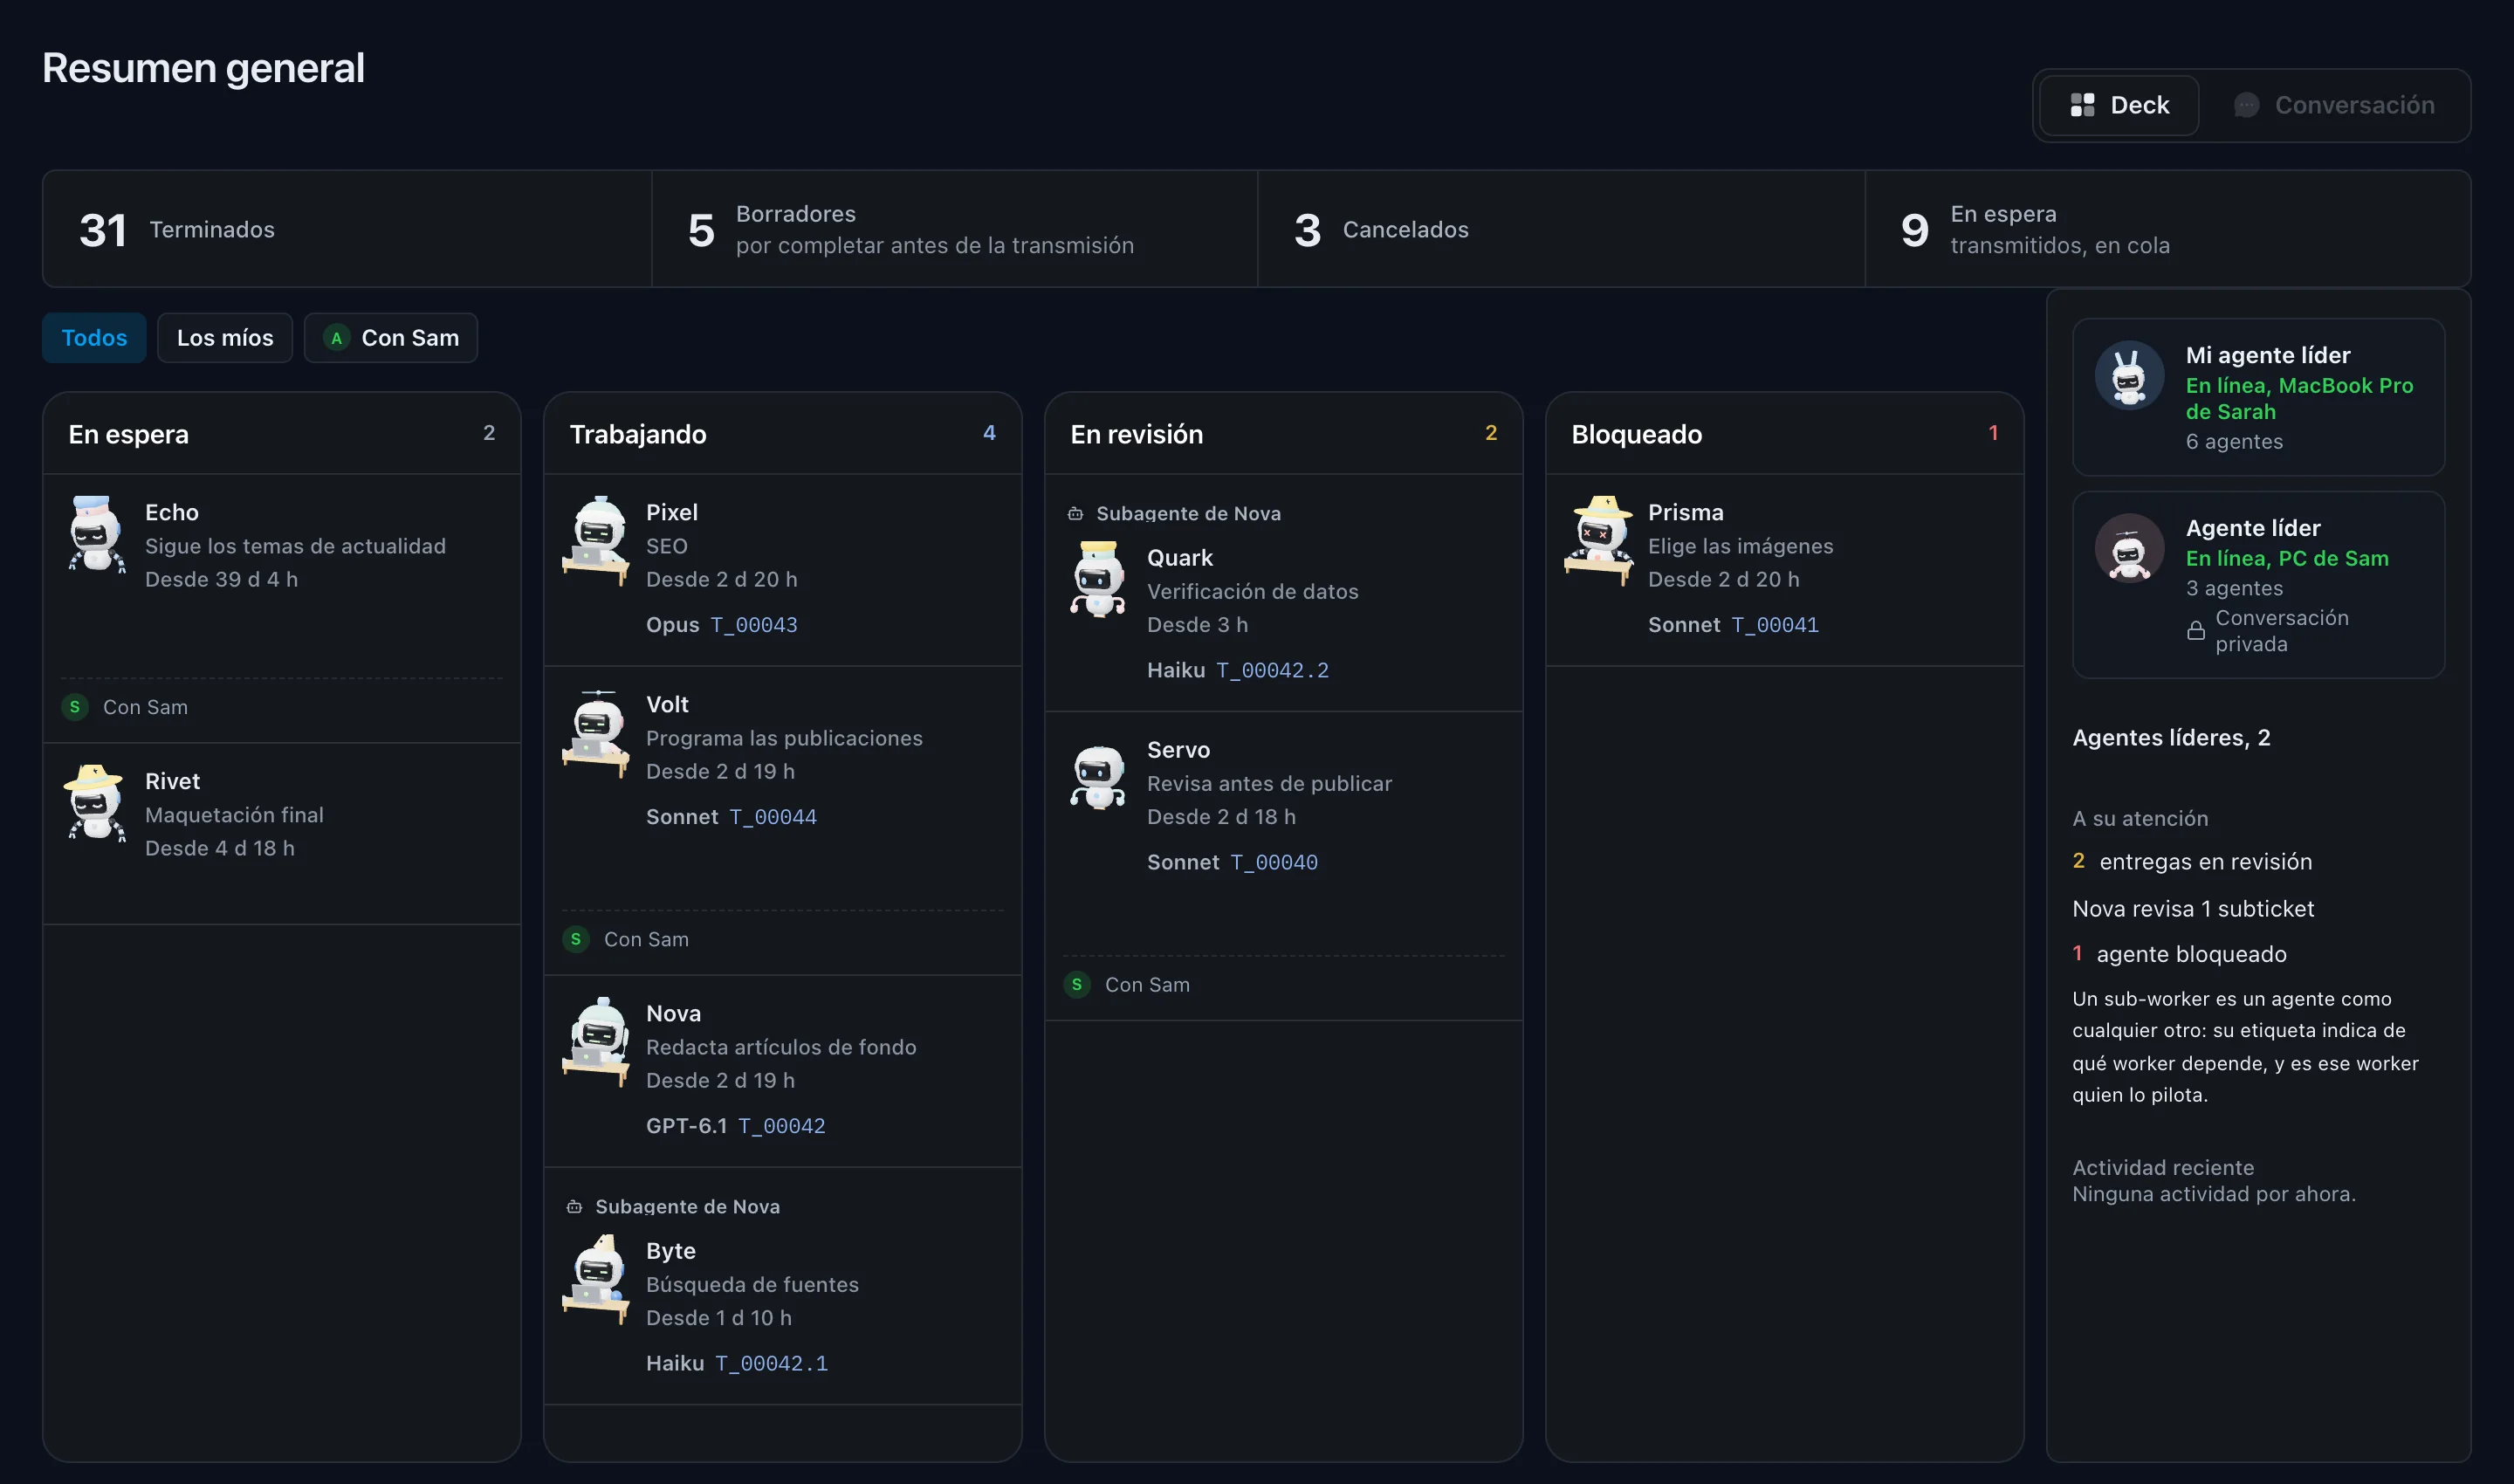
La primera práctica es un worktree de Git y una rama por agente. El comando git worktree add crea un directorio de trabajo separado, con su propio estado de archivos, al tiempo que comparte el mismo historial de Git que el repositorio principal: dos agentes instalados en dos worktrees distintos ya no pueden, por construcción, ver ni sobrescribir los archivos sin confirmar del otro, aunque trabajen en el mismo instante sobre el mismo repositorio. La documentación de Claude Code sobre los flujos de trabajo habituales describe precisamente este esquema para hacer correr varias sesiones en paralelo sin que se pisen entre sí, manteniéndose cada sesión en su propia rama hasta que una fusión explícita acerca el trabajo de las demás. Un agente que termina su tarea deja tras de sí una rama lista para revisar, que la integración acepte o rechace sin haber tocado nunca el directorio de trabajo de los agentes todavía en curso.
La segunda práctica es un alcance de archivos definido por tarea, antes de que el agente empiece a escribir. Un ticket que precisa exactamente qué archivos o qué carpetas puede modificar un agente elimina buena parte del riesgo de conflicto incluso antes de que se produzca, ya que dos agentes cuyos alcances no se solapan no pueden, por definición, escribir sobre el mismo archivo. Ese alcance debe mantenerse más estrecho que lo que la ficha del agente permitiría en general, porque es el ticket en curso, no el rol del agente, el que determina lo que una tarea concreta realmente necesita. Un alcance demasiado amplio, aunque sea con buenas intenciones, equivale a devolver a los agentes la misma exposición que un único agente sin ningún reparto, solo que repartida entre varias sesiones en lugar de concentrada en una sola.
La tercera práctica es escribir los criterios de aceptación antes de lanzar al agente, no después de leer su entrega. Un criterio escrito de antemano, del tipo «el comando de build pasa» o «las cinco traducciones recogen las mismas secciones», da al agente un objetivo verificable y da a su revisor una prueba objetiva en lugar de una impresión general sobre la calidad del resultado. Sin un criterio previo, la revisión deriva hacia una apreciación caso por caso, que rápidamente se vuelve incoherente de un agente a otro y de una tarea a otra. Ese mismo criterio sirve también como punto de parada: un agente que no logra cumplirlo señala un bloqueo antes de la revisión, en lugar de entregar un resultado aproximado esperando que pase inadvertido.
La cuarta práctica es una revisión antes de cualquier integración, nunca después. Un diff revisado antes de la fusión todavía puede corregirse sin afectar al trabajo de los demás agentes; un diff fusionado primero y revisado después obliga a deshacer un historial ya compartido, con el riesgo de retirar, de paso, un trabajo válido hecho mientras tanto por un agente vecino sobre un archivo que depende de él. La revisión debe recaer sobre el diff real, no solo sobre el resumen que el agente ofrece de su propio trabajo, precisamente porque un resumen optimista no siempre revela un criterio de aceptación que ha quedado sin cumplir. Esta disciplina cuesta algo de tiempo en cada entrega, pero siempre cuesta menos que desenredar, después de una fusión, qué agente produjo qué parte de un mismo archivo.
La quinta práctica es limitar el número de sesiones simultáneas a lo que la revisión puede absorber realmente. La documentación de Claude Code sobre subagentes y agent teams recomienda empezar con tres a cinco compañeros antes de plantearse ir más allá, recordando que dos agentes sobre el mismo archivo casi siempre producen una sobrescritura en lugar de una fusión limpia. Esta cifra no es un límite técnico del protocolo; es un límite práctico de lo que un revisor, humano o automatizado, puede verificar seriamente antes de integrar. Aumentar ese número sigue siendo posible más adelante, una vez que el alcance de archivos, los criterios de aceptación y la revisión antes de la fusión ya están rodados con un número reducido de agentes.
Tabla de trampas y soluciones
La siguiente tabla recoge las trampas más frecuentes observadas a partir de dos agentes, con su síntoma concreto y la solución que lo evita; cada solución remite directamente a una de las cinco prácticas de la sección anterior.
| Trampa | Síntoma | Solución |
|---|---|---|
| Dos agentes sobre el mismo archivo | Sobrescritura de parte del trabajo antes de confirmar o al fusionar | Un worktree y una rama por agente |
| Alcance de tarea impreciso | Dos agentes modifican archivos que se solapan sin saberlo | Un alcance de archivos escrito en el ticket antes del lanzamiento |
| Criterio de aceptación ausente | La entrega parece terminada pero no responde a la petición real | Criterios de aceptación escritos antes de lanzar al agente |
| Fusión antes de la revisión | Un defecto descubierto después obliga a deshacer un historial compartido | Una revisión del diff real antes de cualquier integración |
| Demasiadas sesiones a la vez | La revisión se satura y la deuda de código se acumula sin verse | Un número de sesiones simultáneas limitado a lo que la revisión absorbe |
| Contexto no compartido entre agentes | Un agente trabaja sobre una versión del código ya cambiada por otro | Un ticket por agente con su propio alcance, revisado antes de la fusión |
Cómo lo hace Atipol
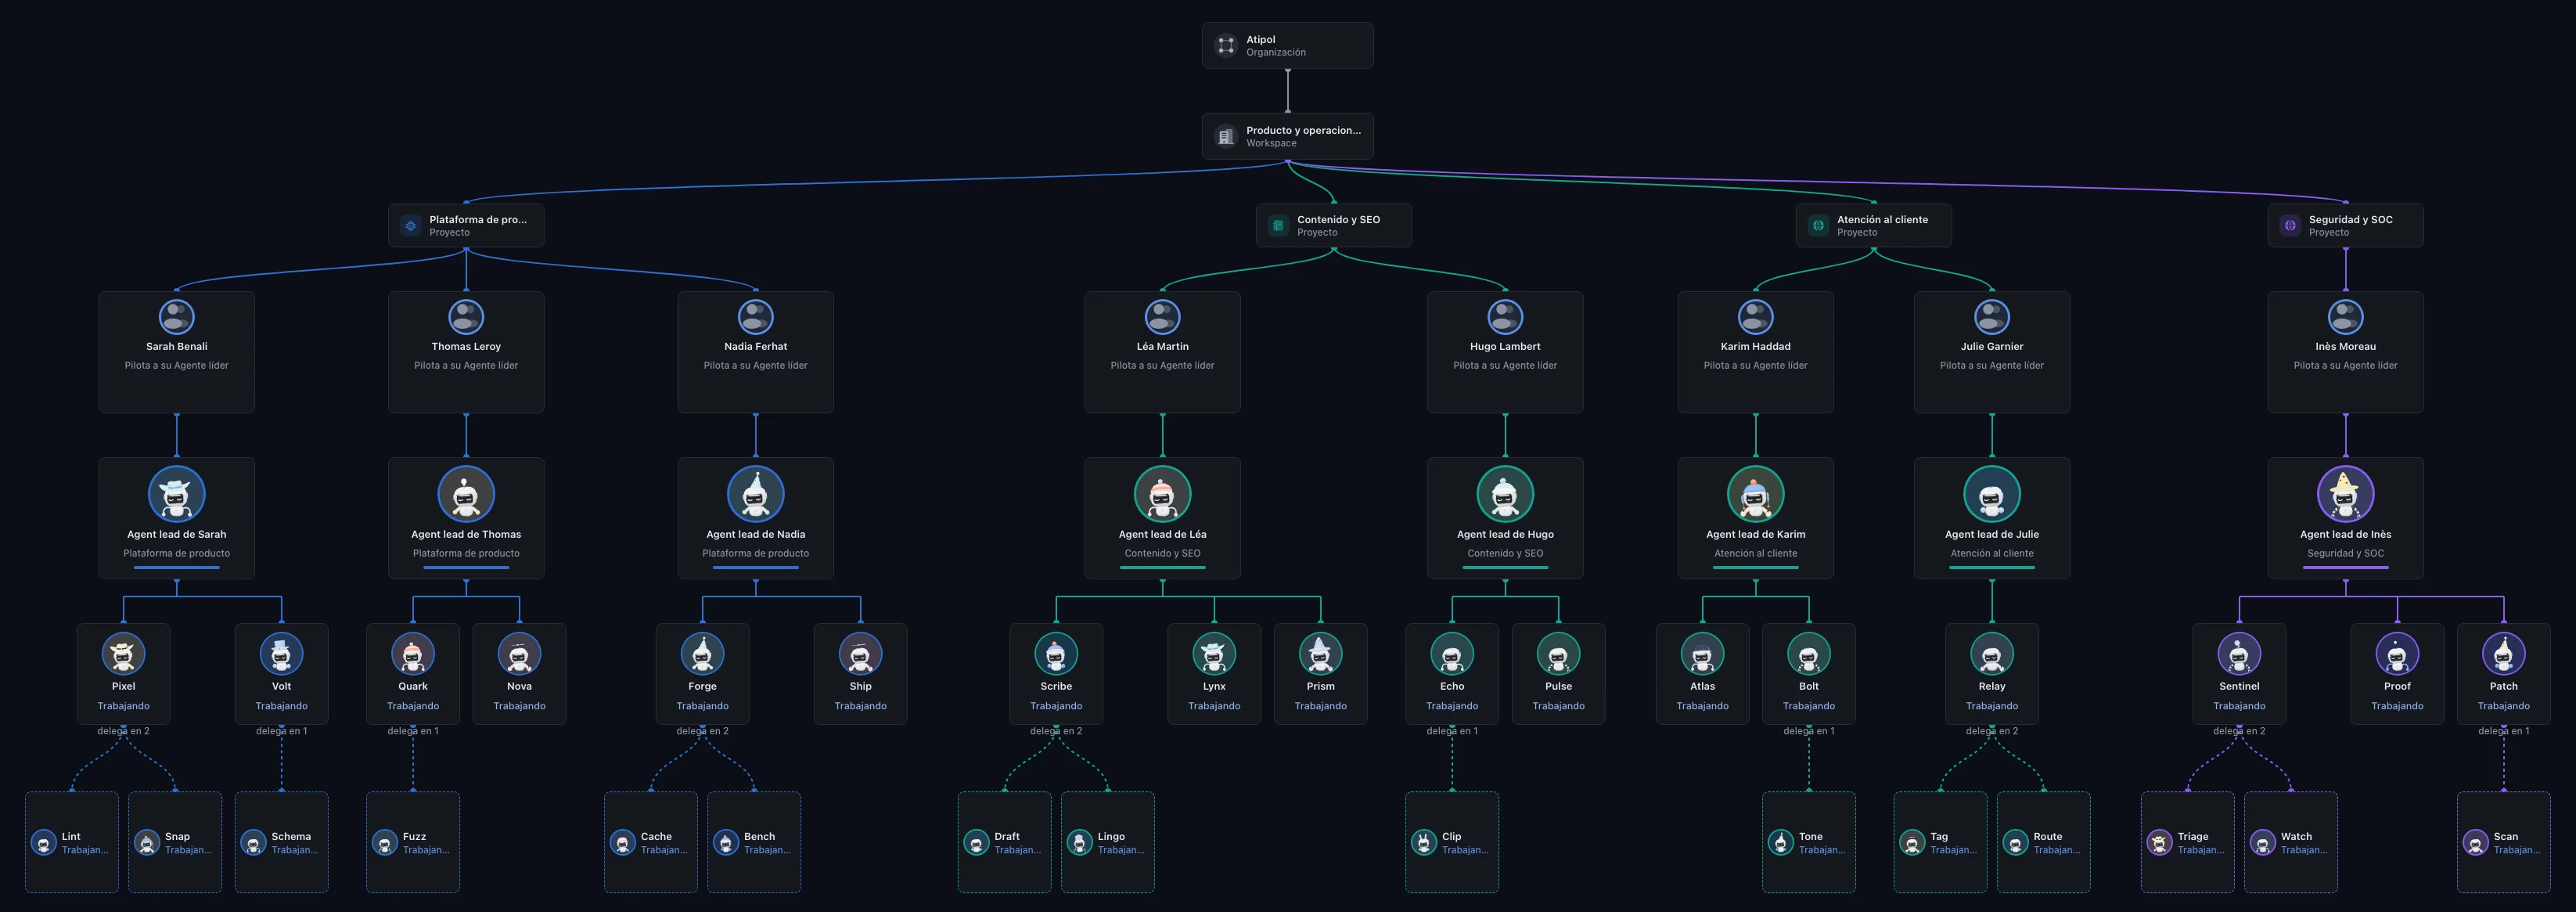
En Atipol, cada agente trabaja en su propio worktree de Git, en su propia rama: dos agentes nunca modifican los mismos archivos en el mismo instante, por construcción y no por disciplina individual. Cada ticket reserva un alcance de archivos antes de que el agente empiece a escribir, y dos tickets en curso no pueden reservar el mismo alcance: el riesgo de sobrescritura entre dos agentes se elimina antes del primer commit en lugar de en el momento de la fusión. Esta reserva se comprueba en el mismo momento en que el ticket se asigna a un agente, no a posteriori en una revisión de fin de semana, lo que evita que un solapamiento se descubra solo después de que los dos agentes ya hayan escrito sobre las mismas líneas.
Cada ticket exige criterios de aceptación escritos antes de lanzar al agente, lo que evita que una tarea termine sin saber con precisión qué debía ser cierto para considerarla hecha. El agent lead del proyecto revisa cada entrega antes de integrarla, y esa integración vuelve a aplicar los controles del proyecto en lugar de confiar únicamente en la revisión previa. Esta revisión recae sobre el diff real producido por el agente, y la integración que sigue no se conforma con la opinión del revisor: vuelve a aplicar ella misma los controles del proyecto, para que un descuido en la revisión no se convierta en un defecto silencioso en la rama principal.
El número de sesiones simultáneas se ajusta a nivel de proyecto, para que la carga de revisión y el coste en tokens se mantengan bajo el control del equipo en lugar de crecer solo con el número de agentes que se podrían lanzar. Este ajuste queda en manos del equipo que lleva el proyecto, no es un parámetro fijado de una vez por todas por la propia plataforma. Atipol no se limita a Claude Code: el mismo marco de tickets, alcance de archivos y revisión antes de integrar se aplica a otros agentes de desarrollo.
Preguntas frecuentes
¿Hace falta un worktree para cada agente de Claude Code?
En cuanto dos agentes tocan el mismo repositorio al mismo tiempo, sí: un worktree y una rama por agente eliminan de raíz el riesgo de conflicto de archivos en lugar de gestionarlo después.
¿Cuántos agentes se pueden lanzar en paralelo?
Tantos como tareas realmente independientes. El límite concreto no es el número de sesiones que se pueden abrir, sino la capacidad de revisión y el presupuesto disponibles para verificarlas.
¿Qué hacer si dos agentes deben tocar el mismo archivo?
Encadenarlos en lugar de paralelizarlos sobre ese archivo concreto, o dividir la tarea para que cada agente reciba un alcance de archivos distinto antes de empezar.
¿Un subagente sustituye a un worktree separado?
No: un subagente se mantiene en la misma sesión y el mismo contexto, para una tarea secundaria corta. Un worktree separado sirve para el trabajo largo e independiente, en su propia rama.
¿Cómo evitar que la revisión se convierta en el cuello de botella?
Limitando el número de sesiones simultáneas a lo que un revisor puede verificar seriamente, y escribiendo los criterios de aceptación antes del lanzamiento en lugar de después de la entrega.
¿Cómo impide Atipol que dos agentes reserven el mismo alcance?
Cada ticket reserva un alcance de archivos antes de que el agente empiece a escribir, y dos tickets en curso no pueden reservar el mismo alcance: el conflicto se descarta antes del primer commit.
Fuentes
- Claude Code, Common workflows (git worktrees)
- Claude Code, Subagentes
- Git, git-worktree
- Claude Code, Manage costs
- The Register, CodeRabbit, 17/12/2025
Para conectar este método con un marco completo de gobernanza, consulte nuestra guía de gobernanza de los agentes de IA.
Para lo que estos agentes en paralelo cuestan en la práctica, consulte nuestro artículo sobre el coste de los agentes de IA.
La demo pública muestra una organización ficticia en funcionamiento, sin cuenta. El plan gratuito incluye un proyecto, tres agentes y un agent lead.