
Combien coûtent vraiment des agents IA ? Chiffres 2026 et méthode

Pour un agent de code, Anthropic indique pour Claude Code environ 13 $ par développeur et par jour actif, soit 150 à 250 $ par mois. Plusieurs agents en parallèle multiplient ce chiffre, et 85 % des entreprises se trompent de plus de 10 % sur leurs coûts IA. La bonne mesure n'est pas la facture du mois mais le coût par livraison acceptée.
Les postes de coût d'une équipe d'agents IA
Le poste le plus visible dans la facture d'une équipe d'agents IA est l'abonnement ou l'API du modèle : les tokens d'entrée, de sortie et de cache, à des tarifs publiés par chaque fournisseur et qui varient fortement d'un modèle à l'autre. Mais cette seule ligne ne raconte qu'une partie de l'histoire. Le temps humain de cadrage et de relecture, les reprises après une livraison refusée, et les outils qui tournent autour du travail des agents pèsent tout autant sur le coût réel, souvent davantage sur la durée. Ignorer ces postes revient à piloter un budget en ne regardant qu'une seule ligne de la facture, et à découvrir les autres au moment le plus inconfortable, celui du relevé de fin de mois.
Faire travailler plusieurs agents en parallèle amplifie plusieurs de ces postes à la fois, pas seulement celui des tokens. Selon la documentation de Claude Code, une équipe d'agents en mode plan consomme environ sept fois plus de tokens qu'une session seule, parce que chaque agent recharge son propre contexte et que la coordination entre agents ajoute des échanges supplémentaires. Le temps de relecture humaine suit une courbe voisine : plus d'agents en parallèle, c'est plus de livraisons à vérifier dans la même fenêtre de temps, pas automatiquement plus vite si personne n'ajoute de capacité de relecture en face. Le parallélisme fait gagner du temps sur un projet, rarement de l'argent sur la facture complète, sauf à traiter ce choix comme un arbitrage conscient plutôt qu'un réflexe appliqué à chaque ticket.
Le coût des outils autour grandit lui aussi avec le nombre d'agents, même si personne n'y pense au moment de signer un abonnement au modèle. L'orchestration des tickets, le stockage des échanges entre un agent et un ticket, et l'intégration continue qui vérifie chaque livraison avant de la fusionner consomment des ressources indépendantes des tokens, mais indispensables pour que le travail des agents reste traçable. Une équipe qui ne budgète que les tokens découvre souvent ce poste au même moment que la facture d'hébergement ou d'intégration continue grimpe avec le nombre de tickets traités chaque mois.
- Abonnement ou API du modèle : tokens d'entrée, de sortie et de cache, à des tarifs qui varient par fournisseur, par modèle et par taille de contexte.
- Temps humain de cadrage : écrire la mission et les critères d'acceptation d'un ticket avant de lancer un agent dessus.
- Temps humain de relecture : vérifier une livraison avant de l'intégrer, un poste qui ne disparaît jamais, quel que soit le modèle utilisé.
- Reprises après une livraison ratée : un ticket refusé se refait, donc se repaie, en tokens comme en temps humain.
- Outils autour : orchestration des tickets, stockage des échanges et intégration continue, qui tournent même quand aucun agent ne travaille.
Pourquoi le coût par token trompe
Comparer deux modèles sur le seul prix du token conduit presque toujours à la mauvaise conclusion. Un modèle deux fois moins cher au token peut produire une livraison refusée une fois sur deux, alors qu'un modèle plus cher livre du premier coup parce qu'il respecte mieux des critères écrits à l'avance. Le prix du token mesure une consommation, pas un résultat. La question qui compte n'est pas combien coûte ce run, mais combien coûte, au total, le fait d'obtenir une livraison que l'on accepte réellement d'intégrer.
Le bon indicateur est le coût par livraison acceptée : la somme des coûts de tous les runs qu'un ticket a exigés, divisée par le nombre de tickets effectivement intégrés. Un ticket qui a demandé trois tentatives avant d'être accepté doit porter le coût cumulé de ces trois tentatives, pas seulement celui de la dernière. C'est cette division, le coût des runs sur les tickets intégrés, qui révèle si un modèle moins cher au token l'est encore une fois les reprises comptées.
Prenons un exemple chiffré fictif, construit pour illustrer le calcul et non pour décrire un client réel. Un ticket confié à un modèle économique coûte 0,40 € de tokens par run ; faute de critères assez précis, il lui faut trois runs avant une livraison acceptée, soit 1,20 € au total pour un ticket intégré. Le même ticket, confié à un modèle plus cher mais avec des critères écrits à l'avance et une relecture avant intégration, coûte 0,90 € de tokens et passe du premier coup, soit 0,90 € pour un ticket intégré. Sur cet exemple, le modèle le moins cher au token revient in fine plus cher une fois les reprises comptées. Le chiffre exact varie selon chaque équipe et chaque ticket ; ce qui ne varie pas, c'est la nécessité de diviser le coût cumulé par les livraisons réellement acceptées plutôt que par le nombre de runs lancés.
Le même calcul se généralise à l'échelle d'une équipe : il suffit de sommer, sur une période donnée, le coût de tous les runs de tous les tickets, puis de diviser ce total par le nombre de tickets réellement intégrés sur la même période. Deux équipes qui dépensent exactement la même somme en tokens sur un mois peuvent afficher un coût par livraison acceptée très différent si l'une intègre deux fois plus de tickets que l'autre avec le même budget. C'est ce rapport, et non le total des tokens consommés, qui permet de comparer deux modèles, deux équipes ou deux mois entre eux de façon honnête. Suivre uniquement la dépense totale, sans ce dénominateur, revient à comparer des factures sans savoir ce qu'elles ont réellement payé.
Cette même division s'applique quel que soit le fournisseur de modèle retenu : le prix catalogue publié sur une page de tarifs ne dit jamais, à lui seul, combien de runs un ticket donné va réellement demander avant d'être accepté. Deux équipes qui utilisent le même modèle, au même tarif, peuvent obtenir un coût par livraison acceptée très différent selon la clarté de leurs critères et la rigueur de leur relecture avant intégration.
Ignorer cette mesure a un coût réel : selon CIO.com, 85 % des entreprises se trompent de plus de 10 % sur leurs coûts d'IA générative, souvent parce qu'elles suivent la dépense totale sans la rapporter aux livraisons obtenues. Chez Uber, l'usage de Claude Code a épuisé le budget IA annuel en quatre mois avant qu'un plafond par ingénieur ne soit mis en place, un exemple de ce qui arrive quand la dépense est suivie au mois plutôt qu'au ticket.
Les leviers qui changent la facture
Cinq leviers agissent directement sur le coût par livraison acceptée, sans dépendre du fournisseur de modèle choisi. Aucun ne suffit seul : c'est leur combinaison qui fait descendre la facture, parce que chacun attaque un poste de coût différent parmi ceux listés plus haut.
Ces leviers se posent avant de lancer un agent, pas après coup : un critère ajouté une fois la livraison faite ne change rien au coût déjà dépensé. Le cache de prompt, par exemple, suppose que le contexte répété reste identique d'un appel à l'autre, ce qui favorise des fiches de poste stables plutôt que réécrites à chaque ticket. Le choix du modèle par poste, lui, suppose de connaître la difficulté réelle de chaque tâche avant de décider, pas après avoir constaté une reprise.
Chacun de ces leviers agit sur un poste précis parmi ceux listés plus haut. Le choix du modèle par poste et le cache de prompt réduisent directement la ligne abonnement ou API. Les critères écrits avant lancement réduisent le temps humain de cadrage, en évitant les clarifications en cours de route. La relecture avant intégration et les sessions reprises plutôt que relancées réduisent la part du budget qui part dans les reprises, le poste le plus facile à perdre de vue tant qu'aucune livraison n'a encore été refusée. Suivre ces cinq leviers ticket par ticket, plutôt que les appliquer une fois pour toutes en début de projet, est ce qui permet de voir lequel pèse le plus dans un projet donné.
Ces cinq leviers s'appliquent aussi bien à une petite équipe qu'à plusieurs agents en parallèle sur plusieurs projets : seul change le nombre de tickets sur lesquels ils se vérifient chaque mois. Une équipe qui démarre peut les revoir manuellement ticket par ticket ; une équipe plus grande gagne à les suivre dans un tableau de bord qui relie chaque levier à un coût par livraison acceptée mesuré, plutôt qu'estimé a posteriori.
| Levier | Pourquoi il réduit le coût par livraison |
|---|---|
| Choix du modèle par poste | Réserver le modèle le plus capable aux tâches qui risquent une reprise, et un modèle économique aux tâches simples et bien cadrées. |
| Critères écrits avant lancement | Moins d'allers-retours de clarification pendant le run, donc moins de tokens dépensés avant même la première livraison. |
| Relecture avant intégration | Une erreur trouvée avant la fusion coûte une relecture ; trouvée après, elle coûte une correction et un nouveau cycle complet. |
| Sessions reprises plutôt que relancées | Reprendre une session garde le contexte déjà payé en tokens ; relancer de zéro le fait payer une seconde fois. |
| Cache de prompt | Un contexte répété d'un run à l'autre, comme une fiche de poste stable, est facturé au tarif réduit du cache plutôt qu'au tarif plein à chaque appel. |
Comment Atipol mesure
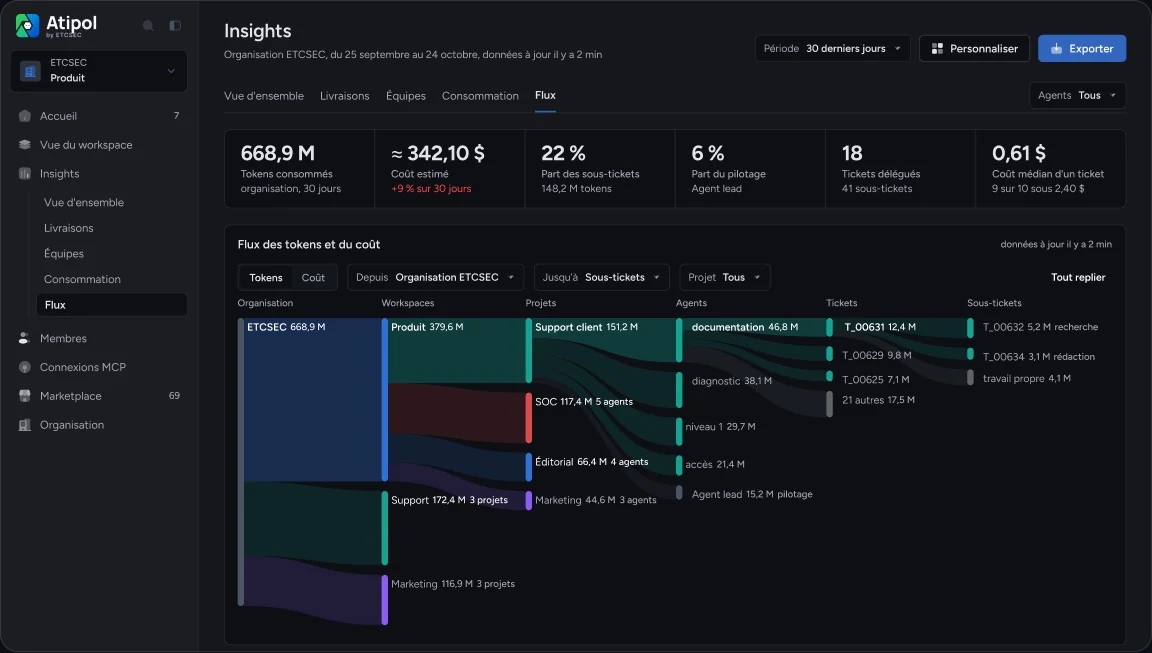
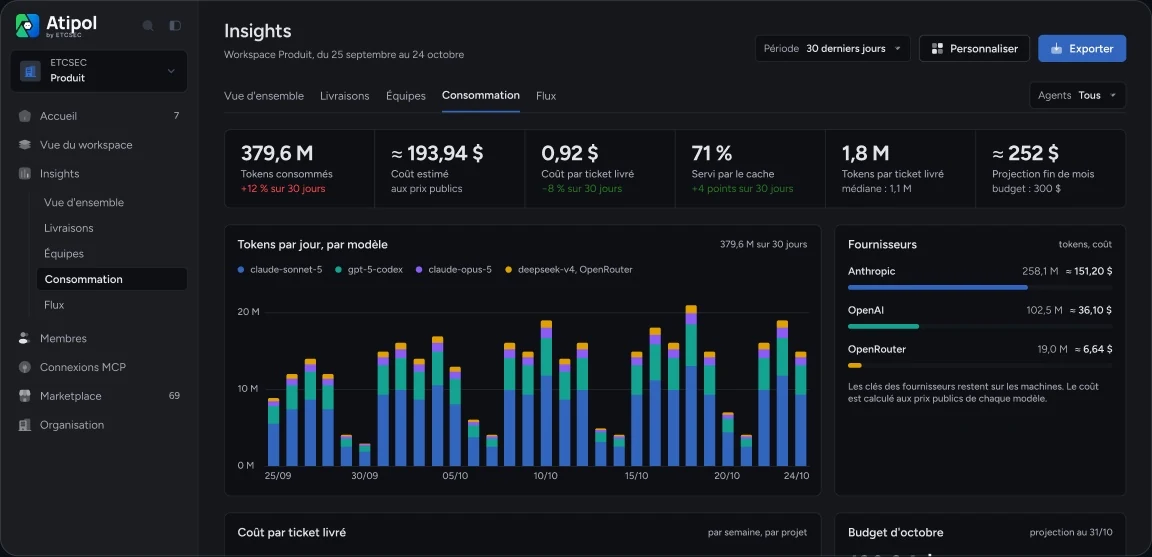
Dans Atipol, le coût se suit en tokens et en euros par run, par ticket, par agent et par modèle : on voit exactement quel poste a consommé quoi, du run isolé jusqu'au sous-ticket, sans attendre la facture de fin de mois pour le découvrir. Ce suivi s'applique aussi bien à un abonnement par siège, prévisible pour l'usage quotidien, qu'à une clé API facturée à l'usage ; beaucoup d'équipes combinent les deux selon les postes. Un budget mensuel par clé de fournisseur se suit avec une alerte à un seuil défini, pour décider de la suite en connaissant déjà la dépense engagée plutôt qu'en la découvrant après coup.
Cette granularité répond à des questions différentes. Le coût par run dit combien a coûté un seul appel au modèle. Le coût par ticket additionne tous les runs d'un ticket, acceptés ou refusés, et se rapporte au nombre de livraisons intégrées pour obtenir le coût par livraison acceptée décrit plus haut. Le coût par agent dit quel poste de travail consomme le plus dans un projet donné. Le coût par modèle dit si le modèle choisi pour un poste reste le bon choix une fois les reprises comptées, ou s'il vaut mieux en changer pour ce poste précis. Ce même suivi se lit aussi par projet : une organisation qui fait tourner plusieurs projets en parallèle voit lequel consomme le plus, et peut ajuster le budget projet par projet plutôt qu'au seul niveau global de l'organisation.
Les offres vont de Gratuit à Entreprise sur devis. Pro, à 19 € TTC par utilisateur et par mois, soit 152 € par an, et Business, à 39 €, ajoutent les fonctions pensées pour une équipe qui fait travailler plusieurs agents sur plusieurs projets. Entreprise se discute sur devis pour les organisations aux besoins spécifiques, par exemple un volume de tickets ou un nombre de projets qui dépasse les formules standard.
Atipol ne fait pas économiser des tokens à votre place : il mesure la dépense, alerte lorsqu'elle approche d'un seuil défini, et exige une confirmation explicite avant de passer à un modèle plus cher, option que vous pouvez aussi interdire poste par poste. La décision reste humaine et informée, pas automatique. Ce suivi par run, par ticket, par agent et par modèle est ce qui permet de calculer, projet après projet, le seul chiffre qui compte réellement : le coût par livraison acceptée décrit plus haut.
Questions fréquentes
Atipol fait-il économiser des tokens ?
Ce n'est pas sa promesse : il mesure la dépense en tokens et en euros par run, par ticket, par agent et par modèle, et exige une confirmation explicite avant de passer à un modèle plus cher, option que vous pouvez aussi interdire poste par poste. Vous décidez en connaissant le coût, pas après la facture.
Comment suivre la dépense par fournisseur de modèle ?
Avec un budget mensuel suivi par clé de fournisseur et une alerte à un seuil défini, pour décider de la suite en connaissant déjà la dépense engagée plutôt qu'en la découvrant à la facture de fin de mois.
Faut-il choisir entre abonnement et API ?
Non : l'abonnement par siège est prévisible pour l'usage quotidien, l'API facture à l'usage pour les pics ponctuels, et beaucoup d'équipes combinent les deux selon les postes de travail.
Qu'est-ce que le coût par livraison acceptée ?
C'est le coût cumulé de tous les runs qu'un ticket a exigés, divisé par le nombre de tickets effectivement intégrés. C'est l'indicateur qui révèle si un modèle moins cher au token l'est encore une fois les reprises comptées.
Le cache de prompt réduit-il vraiment la facture ?
Oui, pour un contexte qui se répète d'un appel à l'autre, comme une fiche de poste stable : il est alors facturé au tarif réduit du cache plutôt qu'au tarif plein à chaque appel, ce que confirment les pages de tarifs des fournisseurs de modèles.
Quelles offres suivent ces coûts chez Atipol ?
Gratuit, Pro à 19 € TTC par utilisateur et par mois (152 € par an), Business à 39 €, et Entreprise sur devis pour les organisations aux besoins spécifiques.
Sources
- Claude Code, Manage costs
- CIO.com, AI cost overruns, 10/09/2025
- Outlook Business, Uber, 2026
- Anthropic (Claude), pricing
- OpenAI, API pricing
Pour estimer précisément ce que cela représente pour votre équipe, utilisez notre calculateur de coût des agents IA.
Pour relier ce coût à un cadre complet, consultez notre guide de gouvernance des agents IA.
La démo publique montre une organisation fictive en fonctionnement, sans compte. L'offre gratuite donne un projet, trois agents et un agent lead.