
¿Cuánto cuestan de verdad los agentes de IA? Cifras de 2026 y método

Para un agente de código, Anthropic indica para Claude Code unos 13 $ por desarrollador y día activo, es decir, de 150 a 250 $ al mes. Varios agentes en paralelo multiplican esa cifra, y el 85 % de las empresas se equivoca en más de un 10 % al estimar sus costes de IA. La medida correcta no es la factura del mes, sino el coste por entrega aceptada.
Las partidas de coste de un equipo de agentes de IA
La partida más visible en la factura de un equipo de agentes de IA es la suscripción o la API del modelo: tokens de entrada, de salida y de caché, a tarifas publicadas por cada proveedor y que varían mucho de un modelo a otro. Pero esa sola línea solo cuenta parte de la historia. El tiempo humano de definición de criterios y de revisión, el trabajo que hay que rehacer tras una entrega rechazada, y las herramientas que giran alrededor del trabajo de los agentes pesan tanto, o más, sobre el coste real a lo largo del tiempo. Ignorar estas partidas es como gestionar un presupuesto mirando una sola línea de la factura, y descubrir el resto en el momento más incómodo: el extracto de fin de mes.
Hacer trabajar a varios agentes en paralelo amplifica varias de estas partidas a la vez, no solo la de los tokens. Según la documentación de Claude Code, un equipo de agentes en modo plan consume unas siete veces más tokens que una sesión individual, porque cada agente vuelve a cargar su propio contexto y la coordinación entre agentes añade más intercambios. El tiempo de revisión humana sigue una curva parecida: más agentes en paralelo significa más entregas que revisar en la misma ventana de tiempo, no automáticamente más rápido si nadie añade capacidad de revisión equivalente. El paralelismo ahorra tiempo en un proyecto, rara vez dinero en la factura completa, salvo que se trate como una decisión consciente y no como un reflejo aplicado a cada ticket.
El coste de las herramientas alrededor del trabajo también crece con el número de agentes, aunque nadie piense en ello al contratar una suscripción al modelo. La orquestación de tickets, el almacenamiento de los intercambios entre un agente y un ticket, y la integración continua que verifica cada entrega antes de fusionarla consumen recursos independientes de los tokens, pero indispensables para que el trabajo de los agentes siga siendo trazable. Un equipo que solo presupuesta tokens suele descubrir esta partida justo cuando la factura de alojamiento o de integración continua crece con el número de tickets tratados cada mes.
- Suscripción o API del modelo: tokens de entrada, de salida y de caché, a tarifas que varían por proveedor, por modelo y por tamaño del contexto.
- Tiempo humano de definición: escribir la misión y los criterios de aceptación de un ticket antes de lanzar un agente sobre él.
- Tiempo humano de revisión: comprobar una entrega antes de integrarla, una partida que nunca desaparece, sea cual sea el modelo usado.
- Trabajo que rehacer tras una entrega fallida: un ticket rechazado se rehace, así que se vuelve a pagar, en tokens y en tiempo humano.
- Herramientas alrededor: orquestación de tickets, almacenamiento de los intercambios e integración continua, que funcionan aunque ningún agente esté trabajando.
Por qué el coste por token engaña
Comparar dos modelos solo por el precio del token lleva casi siempre a la conclusión equivocada. Un modelo dos veces más barato por token puede producir una entrega rechazada una de cada dos veces, mientras que un modelo más caro entrega a la primera porque respeta mejor criterios escritos de antemano. El precio del token mide un consumo, no un resultado. La pregunta que importa no es cuánto cuesta este run, sino cuánto cuesta, en total, conseguir una entrega que realmente se acepta integrar.
El indicador correcto es el coste por entrega aceptada: la suma de los costes de todos los runs que exigió un ticket, dividida entre el número de tickets efectivamente integrados. Un ticket que necesitó tres intentos antes de ser aceptado debe cargar con el coste acumulado de esos tres intentos, no solo el del último. Es esta división, el coste de los runs sobre los tickets integrados, la que revela si un modelo más barato por token lo sigue siendo una vez contado el trabajo rehecho.
Tomemos un ejemplo numérico ficticio, construido para ilustrar el cálculo y no para describir a un cliente real. Un ticket encargado a un modelo económico cuesta 0,40 € de tokens por run; por falta de criterios suficientemente precisos, necesita tres runs antes de una entrega aceptada, es decir, 1,20 € en total por un ticket integrado. El mismo ticket, encargado a un modelo más caro pero con criterios escritos de antemano y una revisión antes de integrar, cuesta 0,90 € de tokens y pasa a la primera, es decir, 0,90 € por un ticket integrado. En este ejemplo, el modelo más barato por token acaba saliendo más caro una vez contado el trabajo rehecho. La cifra exacta varía según cada equipo y cada ticket; lo que no varía es la necesidad de dividir el coste acumulado entre las entregas realmente aceptadas y no entre el número de runs lanzados.
El mismo cálculo se generaliza a la escala de un equipo: basta con sumar, durante un periodo dado, el coste de todos los runs de todos los tickets, y dividir ese total entre el número de tickets realmente integrados en el mismo periodo. Dos equipos que gastan exactamente la misma suma en tokens en un mes pueden mostrar un coste por entrega aceptada muy distinto si uno integra el doble de tickets que el otro con el mismo presupuesto. Es esta proporción, y no el total de tokens consumidos, la que permite comparar honestamente dos modelos, dos equipos o dos meses. Seguir solo el gasto total, sin este denominador, equivale a comparar facturas sin saber qué pagaron realmente.
Esta misma división se aplica sea cual sea el proveedor de modelo elegido: el precio de catálogo publicado en una página de tarifas nunca dice, por sí solo, cuántos runs necesitará realmente un ticket dado antes de ser aceptado. Dos equipos que usan el mismo modelo, a la misma tarifa, pueden obtener un coste por entrega aceptada muy distinto según la claridad de sus criterios y el rigor de su revisión antes de integrar.
Ignorar esta medida tiene un coste real: según CIO.com, el 85 % de las empresas se equivoca en más de un 10 % al estimar sus costes de IA generativa, a menudo porque siguen el gasto total sin relacionarlo con las entregas obtenidas. En Uber, el uso de Claude Code agotó el presupuesto de IA anual en cuatro meses antes de que se fijara un límite por ingeniero, un ejemplo de lo que ocurre cuando el gasto se sigue por mes en lugar de por ticket.
Las palancas que cambian la factura
Cinco palancas actúan directamente sobre el coste por entrega aceptada, sin depender del proveedor de modelo elegido. Ninguna basta por sí sola: es su combinación la que hace bajar la factura, porque cada una ataca una partida de coste distinta de las enumeradas más arriba.
Estas palancas se fijan antes de lanzar un agente, no después: un criterio añadido una vez hecha la entrega no cambia nada del coste ya gastado. La caché de prompt, por ejemplo, supone que el contexto repetido se mantiene idéntico de una llamada a otra, lo que favorece fichas de puesto estables en lugar de reescritas en cada ticket. La elección del modelo por puesto, por su parte, supone conocer la dificultad real de cada tarea antes de decidir, no después de constatar un trabajo rehecho.
Cada una de estas palancas actúa sobre una partida precisa de las enumeradas más arriba. La elección del modelo por puesto y la caché de prompt reducen directamente la línea de suscripción o API. Los criterios escritos de antemano reducen el tiempo humano de definición, al evitar idas y vueltas de aclaración durante el run. La revisión antes de integrar y las sesiones retomadas en lugar de relanzadas reducen la parte del presupuesto que se va en trabajo rehecho, la partida más fácil de perder de vista mientras ninguna entrega ha sido todavía rechazada. Seguir estas cinco palancas ticket a ticket, en lugar de aplicarlas de una vez al inicio del proyecto, es lo que permite ver cuál pesa más en un proyecto dado.
Estas cinco palancas se aplican tanto a un equipo pequeño como a varios agentes en paralelo en varios proyectos: solo cambia el número de tickets sobre los que se verifican cada mes. Un equipo que empieza puede revisarlas manualmente, ticket a ticket; un equipo más grande gana siguiéndolas en un panel que vincula cada palanca a un coste por entrega aceptada medido, y no estimado a posteriori.
| Palanca | Por qué reduce el coste por entrega |
|---|---|
| Elección del modelo por puesto | Reservar el modelo más capaz para las tareas con riesgo de trabajo rehecho, y un modelo económico para las tareas simples y bien definidas. |
| Criterios escritos antes del lanzamiento | Menos idas y vueltas de aclaración durante el run, así que menos tokens gastados antes incluso de la primera entrega. |
| Revisión antes de integrar | Un error encontrado antes de fusionar cuesta una revisión; encontrado después, cuesta una corrección y un ciclo completo nuevo. |
| Sesiones retomadas en lugar de relanzadas | Retomar una sesión conserva el contexto ya pagado en tokens; relanzar desde cero lo hace pagar una segunda vez. |
| Caché de prompt | Un contexto repetido de un run a otro, como una ficha de puesto estable, se factura a la tarifa reducida de la caché en lugar de la tarifa plena en cada llamada. |
Cómo mide Atipol
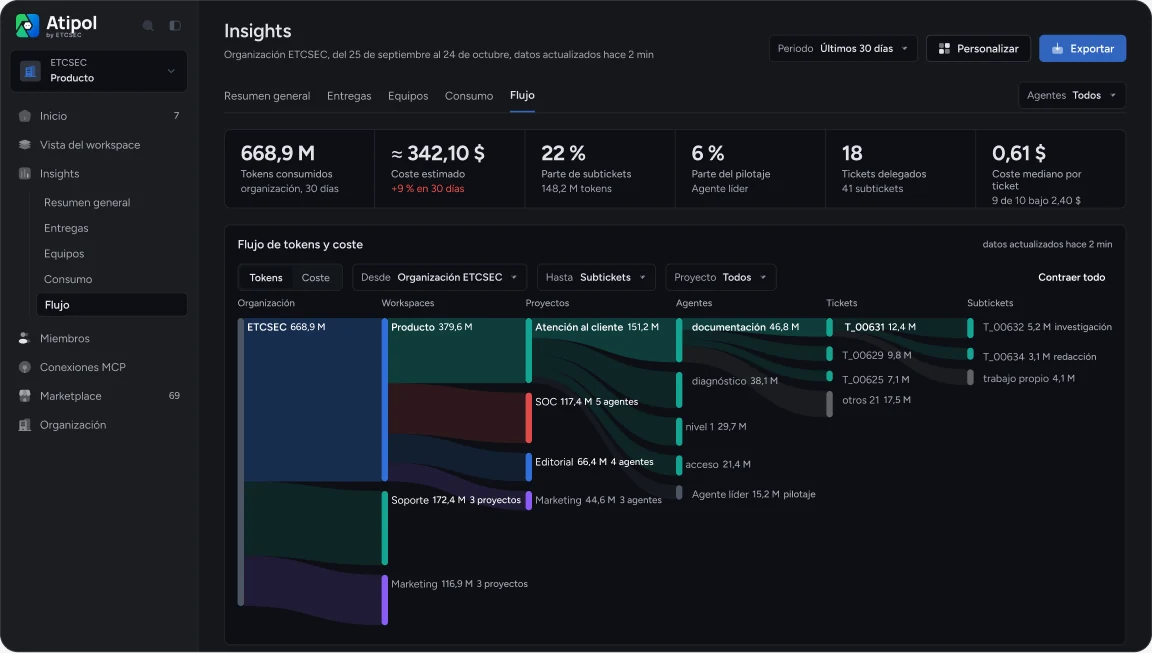
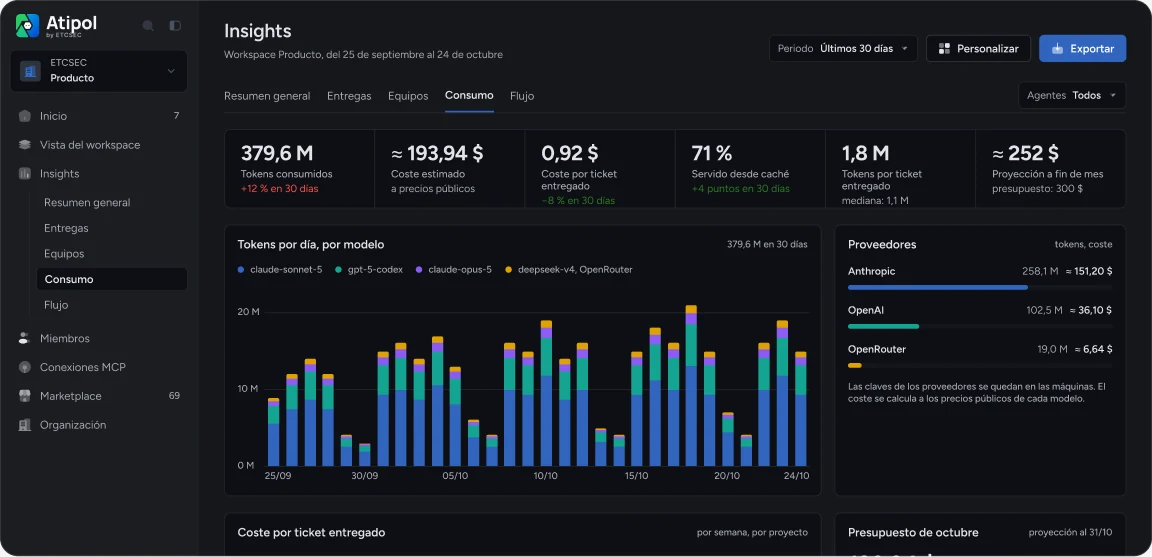
En Atipol, el coste se sigue en tokens y en euros por run, por ticket, por agente y por modelo: se ve exactamente qué partida ha consumido qué, desde el run aislado hasta el subticket, sin esperar a la factura de fin de mes para descubrirlo. Este seguimiento se aplica tanto a una suscripción por puesto, previsible para el uso diario, como a una clave de API facturada por uso; muchos equipos combinan ambas según el puesto. Un presupuesto mensual por clave de proveedor se sigue con una alerta a un umbral definido, para decidir el siguiente paso conociendo ya el gasto comprometido en lugar de descubrirlo después.
Esta granularidad responde a preguntas distintas. El coste por run dice cuánto costó una sola llamada al modelo. El coste por ticket suma todos los runs de un ticket, aceptados o rechazados, y se relaciona con el número de entregas integradas para obtener el coste por entrega aceptada descrito más arriba. El coste por agente dice qué puesto consume más en un proyecto dado. El coste por modelo dice si el modelo elegido para un puesto sigue siendo la opción correcta una vez contado el trabajo rehecho, o si conviene cambiarlo para ese puesto concreto. Ese mismo seguimiento también se lee por proyecto: una organización que hace funcionar varios proyectos en paralelo ve cuál consume más, y puede ajustar el presupuesto proyecto por proyecto en lugar de solo al nivel global de la organización.
Las ofertas van de Gratis a Empresa bajo presupuesto. Pro, a 19 € con IVA por usuario y mes, es decir, 152 € al año, y Business, a 39 €, añaden las funciones pensadas para un equipo que hace trabajar a varios agentes en varios proyectos. Empresa se negocia bajo presupuesto para las organizaciones con necesidades específicas, por ejemplo un volumen de tickets o un número de proyectos que supera las fórmulas estándar.
Atipol no ahorra tokens en su lugar: mide el gasto, avisa cuando se acerca a un umbral definido, y exige una confirmación explícita antes de pasar a un modelo más caro, opción que también puede prohibir puesto por puesto. La decisión sigue siendo humana e informada, no automática. Este seguimiento por run, por ticket, por agente y por modelo es lo que permite calcular, proyecto tras proyecto, la única cifra que realmente importa: el coste por entrega aceptada descrito más arriba.
Preguntas frecuentes
¿Atipol ahorra tokens?
No es lo que promete: mide el gasto en tokens y en euros por run, por ticket, por agente y por modelo, y exige una confirmación explícita antes de pasar a un modelo más caro, opción que también puede prohibir puesto por puesto. Usted decide conociendo el coste, no después de la factura.
¿Cómo se sigue el gasto por proveedor de modelo?
Con un presupuesto mensual seguido por clave de proveedor y una alerta a un umbral definido, para decidir el siguiente paso conociendo ya el gasto comprometido en lugar de descubrirlo en la factura de fin de mes.
¿Hay que elegir entre suscripción y API?
No: la suscripción por puesto es previsible para el uso diario, la API factura por uso para los picos puntuales, y muchos equipos combinan ambas según el puesto de trabajo.
¿Qué es el coste por entrega aceptada?
Es el coste acumulado de todos los runs que exigió un ticket, dividido entre el número de tickets efectivamente integrados. Es el indicador que revela si un modelo más barato por token lo sigue siendo una vez contado el trabajo rehecho.
¿La caché de prompt reduce de verdad la factura?
Sí, para un contexto que se repite de una llamada a otra, como una ficha de puesto estable: se factura entonces a la tarifa reducida de la caché en lugar de la tarifa plena en cada llamada, como confirman las páginas de tarifas de los proveedores de modelos.
¿Qué ofertas de Atipol siguen estos costes?
Gratis, Pro a 19 € con IVA por usuario y mes (152 € al año), Business a 39 €, y Empresa bajo presupuesto para las organizaciones con necesidades específicas.
Fuentes
- Claude Code, Manage costs
- CIO.com, AI cost overruns, 10/09/2025
- Outlook Business, Uber, 2026
- Anthropic (Claude), pricing
- OpenAI, API pricing
Para estimar con precisión lo que esto supone para su equipo, use nuestro calculador de coste de los agentes de IA.
Para conectar este coste con un marco completo, consulte nuestra guía de gobernanza de los agentes de IA.
La demo pública muestra una organización ficticia en funcionamiento, sin cuenta. El plan gratuito incluye un proyecto, tres agentes y un agent lead.