
Was kosten KI-Agenten wirklich? Zahlen 2026 und Methode

Für einen Coding-Agenten nennt Anthropic bei Claude Code etwa 13 $ pro Entwickler und aktivem Tag, also 150 bis 250 $ pro Monat. Mehrere parallele Agenten vervielfachen diesen Wert, und 85 % der Unternehmen verschätzen sich bei ihren KI-Kosten um mehr als 10 %. Die richtige Kennzahl ist nicht die Monatsrechnung, sondern die Kosten pro abgenommener Lieferung.
Die Kostenposten eines Teams von KI-Agenten
Der sichtbarste Posten in der Rechnung eines Teams von KI-Agenten ist das Abonnement oder die API des Modells: Eingabe-, Ausgabe- und Cache-Tokens, zu Tarifen, die jeder Anbieter veröffentlicht und die von Modell zu Modell stark schwanken. Aber diese eine Zeile erzählt nur einen Teil der Geschichte. Die menschliche Zeit für Briefing und Review, die Nacharbeit nach einer abgelehnten Lieferung und die Werkzeuge rund um die Arbeit der Agenten wiegen genauso schwer auf den tatsächlichen Kosten, oft sogar schwerer über die Zeit. Diese Posten zu ignorieren bedeutet, ein Budget zu steuern, indem man nur eine Zeile der Rechnung betrachtet, und den Rest im unangenehmsten Moment zu entdecken: beim Kontoauszug zum Monatsende.
Mehrere Agenten parallel arbeiten zu lassen verstärkt gleich mehrere dieser Posten, nicht nur den der Tokens. Laut der Dokumentation von Claude Code verbraucht ein Agententeam im Plan-Modus etwa siebenmal so viele Tokens wie eine einzelne Session, weil jeder Agent seinen eigenen Kontext neu lädt und die Koordination zwischen Agenten zusätzlichen Austausch erzeugt. Die menschliche Review-Zeit folgt einer ähnlichen Kurve: mehr parallele Agenten bedeuten mehr Lieferungen, die im gleichen Zeitfenster zu prüfen sind, nicht automatisch schneller, wenn niemand entsprechend mehr Review-Kapazität bereitstellt. Parallelisierung spart Zeit bei einem Projekt, selten Geld bei der Gesamtrechnung, außer man behandelt sie als bewusste Abwägung und nicht als Reflex bei jedem Ticket.
Auch die Kosten der Werkzeuge rund um die Arbeit wachsen mit der Zahl der Agenten, auch wenn niemand beim Abschluss eines Modell-Abonnements daran denkt. Die Orchestrierung der Tickets, die Speicherung des Austauschs zwischen einem Agenten und einem Ticket sowie die kontinuierliche Integration, die jede Lieferung vor dem Zusammenführen prüft, verbrauchen Ressourcen unabhängig von Tokens, die aber nötig sind, damit die Arbeit der Agenten nachvollziehbar bleibt. Ein Team, das nur Tokens budgetiert, entdeckt diesen Posten oft genau dann, wenn die Hosting- oder CI-Rechnung mit der Zahl der monatlich bearbeiteten Tickets steigt.
- Abonnement oder API des Modells: Eingabe-, Ausgabe- und Cache-Tokens, zu Tarifen, die je nach Anbieter, Modell und Kontextgröße variieren.
- Menschliche Briefing-Zeit: die Mission und die Abnahmekriterien eines Tickets schreiben, bevor ein Agent darauf angesetzt wird.
- Menschliche Review-Zeit: eine Lieferung prüfen, bevor sie integriert wird, ein Posten, der nie verschwindet, unabhängig vom verwendeten Modell.
- Nacharbeit nach einer gescheiterten Lieferung: ein abgelehntes Ticket wird neu gemacht, also auch neu bezahlt, in Tokens wie in menschlicher Zeit.
- Werkzeuge rund um die Arbeit: Ticket-Orchestrierung, Speicherung des Austauschs und kontinuierliche Integration, die auch laufen, wenn kein Agent arbeitet.
Warum die Kosten pro Token täuschen
Zwei Modelle allein am Tokenpreis zu vergleichen führt fast immer zum falschen Schluss. Ein Modell, das halb so teuer pro Token ist, kann in der Hälfte der Fälle eine abgelehnte Lieferung erzeugen, während ein teureres Modell auf Anhieb liefert, weil es vorab geschriebene Kriterien besser einhält. Der Tokenpreis misst einen Verbrauch, kein Ergebnis. Die entscheidende Frage ist nicht, was dieser Run kostet, sondern was es insgesamt kostet, eine Lieferung zu erhalten, die man tatsächlich zu integrieren bereit ist.
Die richtige Kennzahl ist die Kosten pro abgenommener Lieferung: die Summe der Kosten aller Runs, die ein Ticket erforderte, geteilt durch die Zahl der tatsächlich integrierten Tickets. Ein Ticket, das drei Versuche brauchte, bevor es abgenommen wurde, muss die kumulierten Kosten dieser drei Versuche tragen, nicht nur die des letzten. Genau diese Division, die Kosten der Runs über die integrierten Tickets, zeigt, ob ein pro Token günstigeres Modell es bleibt, sobald die Nacharbeit mitgezählt wird.
Nehmen wir ein fiktives Zahlenbeispiel, das nur zur Veranschaulichung der Rechnung dient und keinen realen Kunden beschreibt. Ein Ticket, das einem günstigen Modell anvertraut wird, kostet 0,40 € Tokens pro Run; mangels präziser Kriterien braucht es drei Runs bis zu einer abgenommenen Lieferung, also insgesamt 1,20 € für ein integriertes Ticket. Dasselbe Ticket, einem teureren Modell anvertraut, aber mit vorab geschriebenen Kriterien und einem Review vor der Integration, kostet 0,90 € Tokens und gelingt auf Anhieb, also 0,90 € für ein integriertes Ticket. In diesem Beispiel ist das pro Token günstigere Modell am Ende teurer, sobald die Nacharbeit mitgezählt wird. Die genaue Zahl variiert von Team zu Team und von Ticket zu Ticket; was sich nicht ändert, ist die Notwendigkeit, die kumulierten Kosten durch die tatsächlich abgenommenen Lieferungen zu teilen und nicht durch die Zahl der gestarteten Runs.
Dieselbe Rechnung lässt sich auf ein ganzes Team hochrechnen: Man summiert über einen bestimmten Zeitraum die Kosten aller Runs aller Tickets und teilt diese Summe durch die Zahl der im selben Zeitraum tatsächlich integrierten Tickets. Zwei Teams, die in einem Monat genau denselben Betrag für Tokens ausgeben, können eine sehr unterschiedliche Kosten pro abgenommener Lieferung aufweisen, wenn das eine doppelt so viele Tickets integriert wie das andere bei gleichem Budget. Dieses Verhältnis, nicht die Summe der verbrauchten Tokens, erlaubt es, zwei Modelle, zwei Teams oder zwei Monate ehrlich zu vergleichen. Nur die Gesamtausgaben zu verfolgen, ohne diesen Nenner, heißt, Rechnungen zu vergleichen, ohne zu wissen, was sie tatsächlich bezahlt haben.
Dieselbe Division gilt unabhängig vom gewählten Modellanbieter: Der auf einer Preisseite veröffentlichte Listenpreis sagt für sich genommen nie, wie viele Runs ein bestimmtes Ticket tatsächlich bis zur Abnahme braucht. Zwei Teams, die dasselbe Modell zum selben Tarif nutzen, können eine sehr unterschiedliche Kosten pro abgenommener Lieferung erzielen, je nachdem, wie klar ihre Kriterien und wie konsequent ihr Review vor der Integration ist.
Diese Kennzahl zu ignorieren hat reale Kosten: Laut CIO.com verschätzt sich 85 % der Unternehmen um mehr als 10 % bei ihren Kosten für generative KI, oft weil sie die Gesamtausgaben verfolgen, ohne sie auf die erhaltenen Lieferungen zu beziehen. Bei Uber hat die Nutzung von Claude Code das KI-Jahresbudget in vier Monaten aufgebraucht, bevor eine Obergrenze pro Ingenieur eingeführt wurde, ein Beispiel dafür, was passiert, wenn Ausgaben monatlich statt pro Ticket verfolgt werden.
Die Hebel, die an der Rechnung drehen
Fünf Hebel wirken direkt auf die Kosten pro abgenommener Lieferung, unabhängig vom gewählten Modellanbieter. Keiner reicht allein: Erst ihre Kombination senkt die Rechnung, weil jeder einen anderen Kostenposten aus der vorherigen Liste angeht.
Diese Hebel werden gesetzt, bevor ein Agent gestartet wird, nicht danach: Ein Kriterium, das erst nach der Lieferung hinzugefügt wird, ändert nichts an den bereits entstandenen Kosten. Der Prompt-Cache setzt zum Beispiel voraus, dass der wiederholte Kontext von einem Aufruf zum nächsten identisch bleibt, was stabile Rollenprofile begünstigt statt bei jedem Ticket neu geschriebene. Die Wahl des Modells pro Rolle wiederum setzt voraus, die reale Schwierigkeit jeder Aufgabe vor der Entscheidung zu kennen, nicht erst nach festgestellter Nacharbeit.
Jeder dieser Hebel wirkt auf einen genauen Posten aus der vorherigen Liste. Die Wahl des Modells pro Rolle und der Prompt-Cache senken direkt die Zeile Abonnement oder API. Vorab geschriebene Kriterien senken die menschliche Briefing-Zeit, indem sie Hin und Her bei Rückfragen während des Runs vermeiden. Review vor der Integration und fortgesetzte statt neu gestartete Sessions senken den Budgetanteil, der in Nacharbeit fließt, den Posten, den man am leichtesten übersieht, solange noch keine Lieferung abgelehnt wurde. Diese fünf Hebel Ticket für Ticket zu verfolgen, statt sie einmalig zu Projektbeginn anzuwenden, zeigt, welcher in einem bestimmten Projekt am meisten wiegt.
Diese fünf Hebel gelten für ein kleines Team genauso wie für mehrere parallele Agenten über mehrere Projekte: Es ändert sich nur die Zahl der Tickets, an denen sie jeden Monat geprüft werden. Ein Team, das gerade startet, kann sie manuell Ticket für Ticket prüfen; ein größeres Team profitiert davon, sie in einem Dashboard zu verfolgen, das jeden Hebel mit einer gemessenen, nicht nachträglich geschätzten, Kosten pro abgenommener Lieferung verknüpft.
| Hebel | Warum er die Kosten pro Lieferung senkt |
|---|---|
| Modellwahl pro Rolle | Das leistungsfähigste Modell für Aufgaben mit Nacharbeitsrisiko reservieren, ein günstiges Modell für einfache, gut umrissene Aufgaben. |
| Vorab geschriebene Kriterien | Weniger Hin und Her bei Rückfragen während des Runs, also weniger verbrauchte Tokens noch vor der ersten Lieferung. |
| Review vor der Integration | Ein vor dem Zusammenführen gefundener Fehler kostet ein Review; danach gefunden, kostet er eine Korrektur und einen ganzen neuen Zyklus. |
| Fortgesetzte statt neu gestartete Sessions | Eine Session fortzusetzen erhält den bereits in Tokens bezahlten Kontext; von vorn zu starten lässt ihn ein zweites Mal bezahlen. |
| Prompt-Cache | Ein von einem Run zum nächsten wiederholter Kontext, wie ein stabiles Rollenprofil, wird zum reduzierten Cache-Tarif abgerechnet statt zum vollen Tarif bei jedem Aufruf. |
Wie Atipol misst
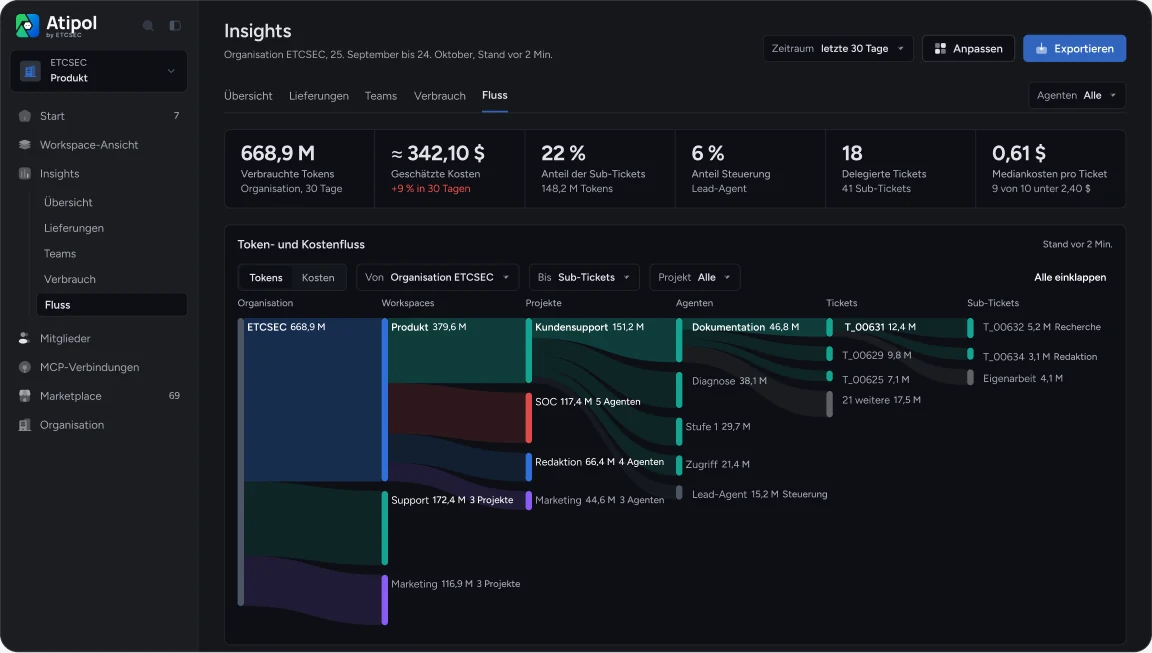
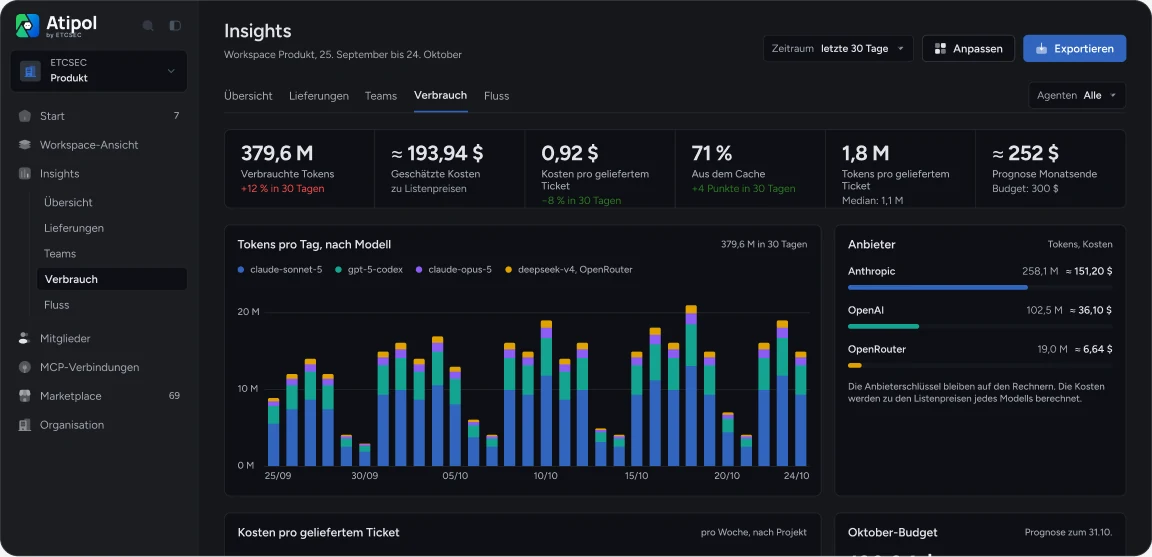
In Atipol werden die Kosten in Tokens und in Euro pro Run, pro Ticket, pro Agent und pro Modell verfolgt: Man sieht genau, welcher Posten was verbraucht hat, von einem einzelnen Run bis zum Sub-Ticket, ohne auf die Monatsrechnung zu warten, um es zu entdecken. Diese Verfolgung gilt gleichermaßen für ein Abonnement pro Lizenz, das für die tägliche Nutzung planbar ist, wie für einen nach Verbrauch abgerechneten API-Schlüssel; viele Teams kombinieren beides je nach Rolle. Ein Monatsbudget pro Anbieterschlüssel wird mit einer Warnung bei einer festgelegten Schwelle verfolgt, damit man das weitere Vorgehen in Kenntnis der bereits entstandenen Ausgaben entscheidet, statt es nachträglich zu entdecken.
Diese Detailtiefe beantwortet unterschiedliche Fragen. Die Kosten pro Run sagen, wie viel ein einzelner Modellaufruf gekostet hat. Die Kosten pro Ticket summieren alle Runs eines Tickets, abgenommen oder abgelehnt, und werden auf die Zahl der integrierten Lieferungen bezogen, um die oben beschriebenen Kosten pro abgenommener Lieferung zu erhalten. Die Kosten pro Agent sagen, welche Rolle in einem bestimmten Projekt am meisten verbraucht. Die Kosten pro Modell sagen, ob das für eine Rolle gewählte Modell nach Abzug der Nacharbeit noch die richtige Wahl ist, oder ob sich ein Wechsel für genau diese Rolle lohnt. Dieselbe Verfolgung liest sich auch pro Projekt: Eine Organisation mit mehreren parallelen Projekten sieht, welches am meisten verbraucht, und kann das Budget projektweise anpassen statt nur auf Ebene der gesamten Organisation.
Die Angebote reichen von Kostenlos bis Enterprise auf Anfrage. Pro, zu 19 € inkl. MwSt. pro Nutzer und Monat, also 152 € im Jahr, und Business, zu 39 €, ergänzen die Funktionen für ein Team, das mehrere Agenten über mehrere Projekte hinweg arbeiten lässt. Enterprise wird auf Anfrage für Organisationen mit besonderen Anforderungen besprochen, etwa ein Ticketvolumen oder eine Projektzahl jenseits der Standardangebote.
Atipol spart nicht an Ihrer Stelle Tokens: Es misst die Ausgaben, warnt, sobald sie sich einer festgelegten Schwelle nähern, und verlangt eine ausdrückliche Bestätigung, bevor zu einem teureren Modell gewechselt wird, eine Option, die Sie auch rollenweise ausschließen können. Die Entscheidung bleibt menschlich und informiert, nicht automatisch. Diese Verfolgung pro Run, pro Ticket, pro Agent und pro Modell ist das, was es erlaubt, Projekt für Projekt die eine Kennzahl zu berechnen, die wirklich zählt: die oben beschriebenen Kosten pro abgenommener Lieferung.
Häufige Fragen
Spart Atipol Tokens?
Das ist nicht das Versprechen: Atipol misst die Ausgaben in Tokens und in Euro pro Run, pro Ticket, pro Agent und pro Modell, und verlangt eine ausdrückliche Bestätigung, bevor zu einem teureren Modell gewechselt wird, eine Option, die Sie auch rollenweise ausschließen können. Sie entscheiden in Kenntnis der Kosten, nicht erst nach der Rechnung.
Wie verfolgt man die Ausgaben pro Modellanbieter?
Mit einem Monatsbudget, das pro Anbieterschlüssel verfolgt wird, und einer Warnung bei einer festgelegten Schwelle, damit man das weitere Vorgehen in Kenntnis der bereits entstandenen Ausgaben entscheidet, statt es bei der Monatsrechnung zu entdecken.
Muss man sich zwischen Abonnement und API entscheiden?
Nein: Ein Abonnement pro Lizenz ist für die tägliche Nutzung planbar, die API rechnet nach Verbrauch für gelegentliche Spitzen ab, und viele Teams kombinieren beides je nach Rolle.
Was sind die Kosten pro abgenommener Lieferung?
Das sind die kumulierten Kosten aller Runs, die ein Ticket erforderte, geteilt durch die Zahl der tatsächlich integrierten Tickets. Es ist die Kennzahl, die zeigt, ob ein pro Token günstigeres Modell es bleibt, sobald die Nacharbeit mitgezählt wird.
Senkt der Prompt-Cache wirklich die Rechnung?
Ja, für einen Kontext, der sich von einem Aufruf zum nächsten wiederholt, wie ein stabiles Rollenprofil: Er wird dann zum reduzierten Cache-Tarif abgerechnet statt zum vollen Tarif bei jedem Aufruf, wie die Preisseiten der Modellanbieter bestätigen.
Welche Atipol-Angebote verfolgen diese Kosten?
Kostenlos, Pro zu 19 € inkl. MwSt. pro Nutzer und Monat (152 € im Jahr), Business zu 39 € und Enterprise auf Anfrage für Organisationen mit besonderen Anforderungen.
Quellen
- Claude Code, Manage costs
- CIO.com, AI cost overruns, 10.09.2025
- Outlook Business, Uber, 2026
- Anthropic (Claude), pricing
- OpenAI, API pricing
Um genau abzuschätzen, was das für Ihr Team bedeutet, nutzen Sie unseren Kostenrechner für KI-Agenten.
Um diese Kosten mit einem vollständigen Rahmenwerk zu verbinden, lesen Sie unseren Leitfaden zur Governance von KI-Agenten.
Die öffentliche Demo zeigt eine fiktive Organisation im laufenden Betrieb, ohne Konto. Der kostenlose Tarif umfasst ein Projekt, drei Agenten und einen Agent Lead.