
Quanto costano davvero gli agenti IA? Numeri 2026 e metodo

Per un agente di codice, Anthropic indica per Claude Code circa 13 $ per sviluppatore e per giorno attivo, cioè da 150 a 250 $ al mese. Più agenti in parallelo moltiplicano questa cifra, e l'85 % delle aziende sbaglia di oltre il 10 % la stima dei propri costi IA. La misura giusta non è la fattura del mese ma il costo per consegna accettata.
Le voci di costo di un team di agenti IA
La voce più visibile nella fattura di un team di agenti IA è l'abbonamento o l'API del modello: token di input, di output e di cache, a tariffe pubblicate da ogni fornitore e che variano molto da un modello all'altro. Ma questa sola voce racconta solo una parte della storia. Il tempo umano di definizione dei criteri e di revisione, il lavoro da rifare dopo una consegna respinta, e gli strumenti che ruotano attorno al lavoro degli agenti pesano altrettanto sul costo reale, spesso di più nel tempo. Ignorare queste voci significa gestire un budget guardando una sola riga della fattura, e scoprire il resto nel momento più scomodo: l'estratto conto di fine mese.
Far lavorare più agenti in parallelo amplifica più di queste voci insieme, non solo quella dei token. Secondo la documentazione di Claude Code, un team di agenti in modalità plan consuma circa sette volte più token di una sessione singola, perché ogni agente ricarica il proprio contesto e il coordinamento tra agenti aggiunge ulteriori scambi. Il tempo di revisione umana segue una curva simile: più agenti in parallelo significa più consegne da verificare nella stessa finestra di tempo, non automaticamente più in fretta se nessuno aggiunge capacità di revisione corrispondente. Il parallelismo fa risparmiare tempo su un progetto, raramente denaro sulla fattura complessiva, a meno di trattarlo come una scelta consapevole e non come un riflesso applicato a ogni ticket.
Il costo degli strumenti attorno al lavoro cresce anch'esso con il numero di agenti, anche se nessuno ci pensa al momento di sottoscrivere un abbonamento al modello. L'orchestrazione dei ticket, l'archiviazione degli scambi tra un agente e un ticket, e l'integrazione continua che verifica ogni consegna prima di unirla consumano risorse indipendenti dai token, ma indispensabili perché il lavoro degli agenti resti tracciabile. Un team che fa il budget solo sui token scopre spesso questa voce proprio quando la fattura di hosting o di integrazione continua cresce con il numero di ticket trattati ogni mese.
- Abbonamento o API del modello: token di input, di output e di cache, a tariffe che variano per fornitore, per modello e per dimensione del contesto.
- Tempo umano di definizione dei criteri: scrivere la missione e i criteri di accettazione di un ticket prima di lanciarci un agente.
- Tempo umano di revisione: verificare una consegna prima di integrarla, una voce che non scompare mai, qualunque sia il modello usato.
- Lavoro da rifare dopo una consegna respinta: un ticket respinto si rifà, quindi si ripaga, in token come in tempo umano.
- Strumenti attorno al lavoro: orchestrazione dei ticket, archiviazione degli scambi e integrazione continua, che girano anche quando nessun agente lavora.
Perché il costo per token inganna
Confrontare due modelli solo sul prezzo del token porta quasi sempre alla conclusione sbagliata. Un modello due volte più economico per token può produrre una consegna respinta una volta su due, mentre un modello più costoso consegna al primo colpo perché rispetta meglio criteri scritti in anticipo. Il prezzo del token misura un consumo, non un risultato. La domanda che conta non è quanto costa questo run, ma quanto costa, in totale, ottenere una consegna che si accetta davvero di integrare.
L'indicatore giusto è il costo per consegna accettata: la somma dei costi di tutti i run richiesti da un ticket, divisa per il numero di ticket effettivamente integrati. Un ticket che ha richiesto tre tentativi prima di essere accettato deve portare il costo cumulato di questi tre tentativi, non solo quello dell'ultimo. È questa divisione, il costo dei run sui ticket integrati, a rivelare se un modello più economico per token lo resta ancora una volta contato il lavoro da rifare.
Prendiamo un esempio numerico fittizio, costruito per illustrare il calcolo e non per descrivere un cliente reale. Un ticket affidato a un modello economico costa 0,40 € di token per run; per criteri non abbastanza precisi, richiede tre run prima di una consegna accettata, cioè 1,20 € in totale per un ticket integrato. Lo stesso ticket, affidato a un modello più costoso ma con criteri scritti in anticipo e una revisione prima dell'integrazione, costa 0,90 € di token e passa al primo colpo, cioè 0,90 € per un ticket integrato. In questo esempio, il modello più economico per token risulta alla fine più caro una volta contato il lavoro da rifare. La cifra esatta varia da un team e da un ticket all'altro; ciò che non varia è la necessità di dividere il costo cumulato per le consegne effettivamente accettate e non per il numero di run lanciati.
Lo stesso calcolo si generalizza a livello di un intero team: basta sommare, in un dato periodo, il costo di tutti i run di tutti i ticket, poi dividere questo totale per il numero di ticket effettivamente integrati nello stesso periodo. Due team che spendono esattamente la stessa somma in token in un mese possono mostrare un costo per consegna accettata molto diverso se uno integra il doppio dei ticket dell'altro con lo stesso budget. È questo rapporto, e non il totale dei token consumati, che permette di confrontare onestamente due modelli, due team o due mesi. Seguire solo la spesa totale, senza questo denominatore, equivale a confrontare fatture senza sapere che cosa hanno davvero pagato.
Questa stessa divisione si applica qualunque sia il fornitore di modello scelto: il prezzo di listino pubblicato su una pagina tariffaria non dice mai, da solo, quanti run un dato ticket richiederà davvero prima di essere accettato. Due team che usano lo stesso modello, alla stessa tariffa, possono ottenere un costo per consegna accettata molto diverso a seconda della chiarezza dei loro criteri e del rigore della loro revisione prima dell'integrazione.
Ignorare questa misura ha un costo reale: secondo CIO.com, l'85 % delle aziende sbaglia di oltre il 10 % la stima dei propri costi di IA generativa, spesso perché segue la spesa totale senza rapportarla alle consegne ottenute. In Uber, l'uso di Claude Code ha esaurito il budget IA annuale in quattro mesi prima dell'introduzione di un tetto per ingegnere, un esempio di ciò che accade quando la spesa viene seguita al mese invece che al ticket.
Le leve che cambiano la fattura
Cinque leve agiscono direttamente sul costo per consegna accettata, indipendentemente dal fornitore di modello scelto. Nessuna basta da sola: è la loro combinazione a far scendere la fattura, perché ciascuna attacca una voce di costo diversa tra quelle elencate sopra.
Queste leve si impostano prima di lanciare un agente, non dopo: un criterio aggiunto a consegna già fatta non cambia nulla del costo già speso. La cache di prompt, per esempio, presuppone che il contesto ripetuto resti identico da una chiamata all'altra, il che favorisce schede di ruolo stabili piuttosto che riscritte a ogni ticket. La scelta del modello per ruolo, a sua volta, presuppone di conoscere la reale difficoltà di ogni compito prima di decidere, non dopo aver constatato un lavoro da rifare.
Ciascuna di queste leve agisce su una voce precisa tra quelle elencate sopra. La scelta del modello per ruolo e la cache di prompt riducono direttamente la riga abbonamento o API. I criteri scritti in anticipo riducono il tempo umano di definizione, evitando andirivieni di chiarimento durante il run. La revisione prima dell'integrazione e le sessioni riprese piuttosto che rilanciate riducono la quota di budget che finisce nel lavoro da rifare, la voce più facile da perdere di vista finché nessuna consegna è stata ancora respinta. Seguire queste cinque leve ticket per ticket, invece di applicarle una volta per tutte a inizio progetto, è ciò che permette di vedere quale pesa di più in un dato progetto.
Queste cinque leve si applicano tanto a un piccolo team quanto a più agenti in parallelo su più progetti: cambia solo il numero di ticket su cui si verificano ogni mese. Un team agli inizi può rivederle manualmente, ticket per ticket; un team più grande guadagna a seguirle in una dashboard che collega ogni leva a un costo per consegna accettata misurato, e non stimato a posteriori.
| Leva | Perché riduce il costo per consegna |
|---|---|
| Scelta del modello per ruolo | Riservare il modello più capace ai compiti a rischio di lavoro da rifare, e un modello economico ai compiti semplici e ben definiti. |
| Criteri scritti prima del lancio | Meno andirivieni di chiarimento durante il run, quindi meno token spesi prima ancora della prima consegna. |
| Revisione prima dell'integrazione | Un errore trovato prima dell'unione costa una revisione; trovato dopo, costa una correzione e un intero nuovo ciclo. |
| Sessioni riprese piuttosto che rilanciate | Riprendere una sessione mantiene il contesto già pagato in token; rilanciare da zero lo fa pagare una seconda volta. |
| Cache di prompt | Un contesto ripetuto da un run all'altro, come una scheda di ruolo stabile, è fatturato alla tariffa ridotta della cache invece che alla tariffa piena a ogni chiamata. |
Come misura Atipol
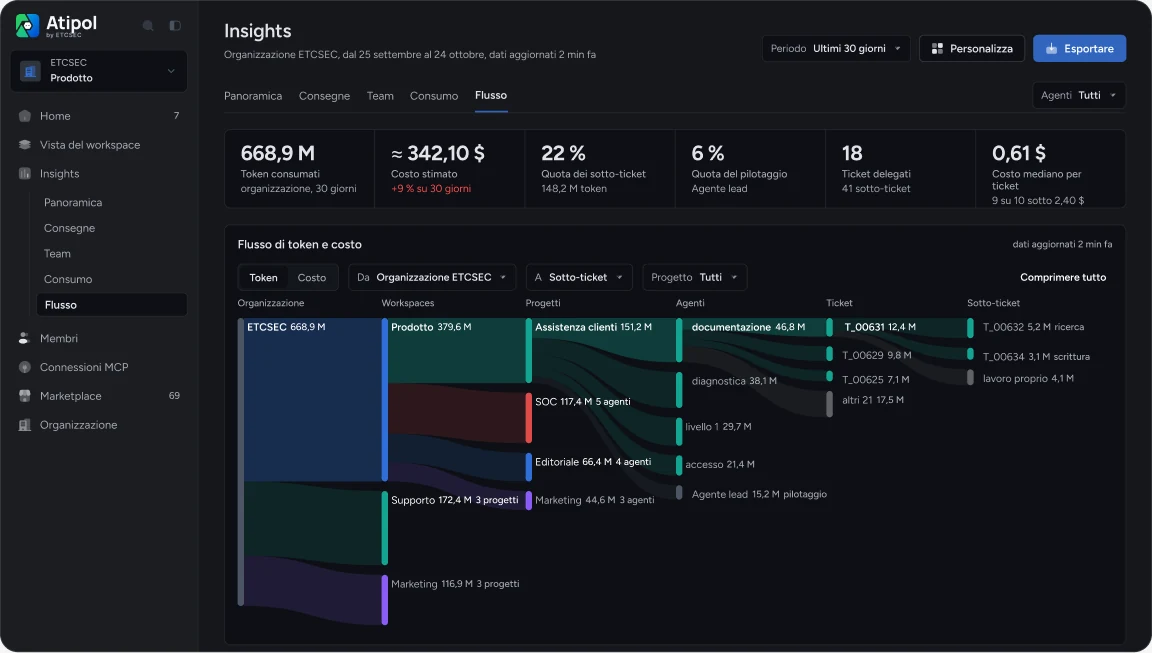
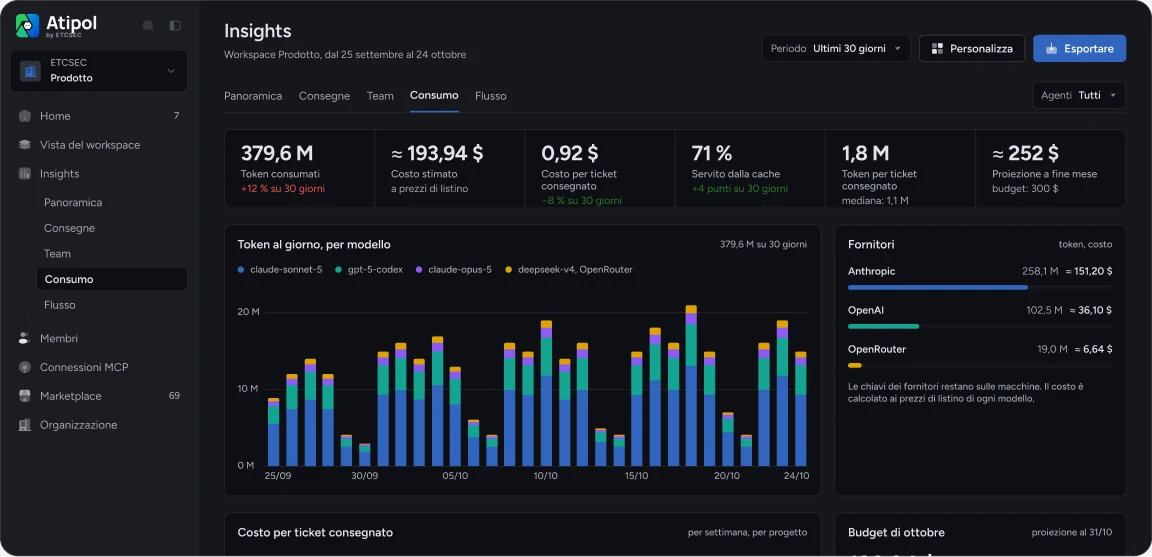
In Atipol, il costo si segue in token e in euro per run, per ticket, per agente e per modello: si vede esattamente quale voce ha consumato cosa, dal singolo run fino al sotto-ticket, senza aspettare la fattura di fine mese per scoprirlo. Questo monitoraggio si applica sia a un abbonamento per postazione, prevedibile per l'uso quotidiano, sia a una chiave API fatturata a consumo; molti team combinano le due cose a seconda del ruolo. Un budget mensile per chiave del fornitore si segue con un avviso a una soglia definita, per decidere il seguito conoscendo già la spesa impegnata invece di scoprirla dopo.
Questa granularità risponde a domande diverse. Il costo per run dice quanto è costata una singola chiamata al modello. Il costo per ticket somma tutti i run di un ticket, accettati o respinti, e si rapporta al numero di consegne integrate per ottenere il costo per consegna accettata descritto sopra. Il costo per agente dice quale ruolo consuma di più in un dato progetto. Il costo per modello dice se il modello scelto per un ruolo resta la scelta giusta una volta contato il lavoro da rifare, o se conviene cambiarlo per quel ruolo preciso. Lo stesso monitoraggio si legge anche per progetto: un'organizzazione che fa girare più progetti in parallelo vede quale consuma di più, e può adattare il budget progetto per progetto invece che solo a livello globale dell'organizzazione.
Le offerte vanno da Gratuito a Enterprise su preventivo. Pro, a 19 € IVA inclusa per utente al mese, cioè 152 € all'anno, e Business, a 39 €, aggiungono le funzioni pensate per un team che fa lavorare più agenti su più progetti. Enterprise si discute su preventivo per le organizzazioni con esigenze specifiche, per esempio un volume di ticket o un numero di progetti che supera le formule standard.
Atipol non fa risparmiare token al posto vostro: misura la spesa, avvisa quando si avvicina a una soglia definita, e richiede una conferma esplicita prima di passare a un modello più costoso, opzione che potete anche vietare ruolo per ruolo. La decisione resta umana e informata, non automatica. Questo monitoraggio per run, per ticket, per agente e per modello è ciò che permette di calcolare, progetto dopo progetto, l'unica cifra che conta davvero: il costo per consegna accettata descritto sopra.
Domande frequenti
Atipol fa risparmiare token?
Non è la sua promessa: misura la spesa in token e in euro per run, per ticket, per agente e per modello, e richiede una conferma esplicita prima di passare a un modello più costoso, opzione che potete anche vietare ruolo per ruolo. Decidete conoscendo il costo, non dopo la fattura.
Come seguire la spesa per fornitore di modello?
Con un budget mensile seguito per chiave del fornitore e un avviso a una soglia definita, per decidere il seguito conoscendo già la spesa impegnata invece di scoprirla alla fattura di fine mese.
Bisogna scegliere tra abbonamento e API?
No: l'abbonamento per postazione è prevedibile per l'uso quotidiano, l'API fattura a consumo per i picchi occasionali, e molti team combinano le due cose a seconda del ruolo.
Che cos'è il costo per consegna accettata?
È il costo cumulato di tutti i run richiesti da un ticket, diviso per il numero di ticket effettivamente integrati. È l'indicatore che rivela se un modello più economico per token lo resta ancora una volta contato il lavoro da rifare.
La cache di prompt riduce davvero la fattura?
Sì, per un contesto che si ripete da una chiamata all'altra, come una scheda di ruolo stabile: viene allora fatturato alla tariffa ridotta della cache invece che alla tariffa piena a ogni chiamata, come confermano le pagine tariffarie dei fornitori di modelli.
Quali offerte Atipol seguono questi costi?
Gratuito, Pro a 19 € IVA inclusa per utente al mese (152 € all'anno), Business a 39 €, ed Enterprise su preventivo per le organizzazioni con esigenze specifiche.
Fonti
- Claude Code, Manage costs
- CIO.com, AI cost overruns, 10/09/2025
- Outlook Business, Uber, 2026
- Anthropic (Claude), pricing
- OpenAI, API pricing
Per stimare con precisione cosa significa per il vostro team, usate il nostro calcolatore del costo degli agenti IA.
Per collegare questo costo a un quadro completo, consultate la nostra guida alla governance degli agenti IA.
La demo pubblica mostra un'organizzazione fittizia in funzione, senza account. L'offerta gratuita include un progetto, tre agenti e un agent lead.