
Quanto custam realmente os agentes de IA? Números de 2026 e método

Para um agente de código, a Anthropic indica para o Claude Code cerca de 13 $ por programador e por dia ativo, ou seja, 150 a 250 $ por mês. Vários agentes em paralelo multiplicam este valor, e 85 % das empresas erram em mais de 10 % na estimativa dos seus custos de IA. A medida certa não é a fatura do mês, mas o custo por entrega aceite.
As rubricas de custo de uma equipa de agentes de IA
A rubrica mais visível na fatura de uma equipa de agentes de IA é a subscrição ou a API do modelo: tokens de entrada, de saída e de cache, a tarifas publicadas por cada fornecedor e que variam muito de um modelo para outro. Mas essa única linha conta apenas parte da história. O tempo humano de definição de critérios e de revisão, o trabalho a refazer após uma entrega recusada, e as ferramentas que giram em torno do trabalho dos agentes pesam tanto, ou mais, no custo real ao longo do tempo. Ignorar estas rubricas é gerir um orçamento olhando apenas para uma linha da fatura, e descobrir o resto no momento mais incómodo: o extrato de fim de mês.
Fazer trabalhar vários agentes em paralelo amplifica várias destas rubricas ao mesmo tempo, não apenas a dos tokens. Segundo a documentação do Claude Code, uma equipa de agentes em modo de planeamento consome cerca de sete vezes mais tokens do que uma sessão única, porque cada agente volta a carregar o seu próprio contexto e a coordenação entre agentes acrescenta mais trocas de mensagens. O tempo de revisão humana segue uma curva parecida: mais agentes em paralelo significa mais entregas a verificar na mesma janela de tempo, não automaticamente mais depressa se ninguém acrescentar capacidade de revisão equivalente. O paralelismo poupa tempo num projeto, raramente dinheiro na fatura completa, a menos que seja tratado como uma escolha consciente e não como um reflexo aplicado a cada ticket.
O custo das ferramentas em torno do trabalho também cresce com o número de agentes, mesmo que ninguém pense nisso ao subscrever um modelo. A orquestração dos tickets, o armazenamento das trocas entre um agente e um ticket, e a integração contínua que verifica cada entrega antes de a integrar consomem recursos independentes dos tokens, mas indispensáveis para que o trabalho dos agentes permaneça rastreável. Uma equipa que só orçamenta tokens descobre muitas vezes esta rubrica no mesmo momento em que a fatura de alojamento ou de integração contínua sobe com o número de tickets tratados a cada mês.
- Subscrição ou API do modelo: tokens de entrada, de saída e de cache, a tarifas que variam por fornecedor, por modelo e por tamanho do contexto.
- Tempo humano de definição: escrever a missão e os critérios de aceitação de um ticket antes de lançar um agente nele.
- Tempo humano de revisão: verificar uma entrega antes de a integrar, uma rubrica que nunca desaparece, seja qual for o modelo usado.
- Trabalho a refazer após uma entrega falhada: um ticket recusado é refeito, logo é pago duas vezes, em tokens e em tempo humano.
- Ferramentas em torno do trabalho: orquestração dos tickets, armazenamento das trocas e integração contínua, que funcionam mesmo quando nenhum agente trabalha.
Porque é que o custo por token engana
Comparar dois modelos apenas pelo preço do token leva quase sempre à conclusão errada. Um modelo duas vezes mais barato por token pode produzir uma entrega recusada metade das vezes, enquanto um modelo mais caro entrega à primeira porque respeita melhor critérios escritos com antecedência. O preço do token mede um consumo, não um resultado. A pergunta que conta não é quanto custa este run, mas quanto custa, no total, obter uma entrega que se aceita mesmo integrar.
O indicador certo é o custo por entrega aceite: a soma dos custos de todos os runs que um ticket exigiu, dividida pelo número de tickets efetivamente integrados. Um ticket que precisou de três tentativas antes de ser aceite deve carregar o custo acumulado dessas três tentativas, não apenas o da última. É esta divisão, o custo dos runs sobre os tickets integrados, que revela se um modelo mais barato por token continua a sê-lo depois de contado o trabalho a refazer.
Tomemos um exemplo numérico fictício, construído para ilustrar o cálculo e não para descrever um cliente real. Um ticket confiado a um modelo económico custa 0,40 € de tokens por run; por falta de critérios suficientemente precisos, precisa de três runs antes de uma entrega aceite, ou seja, 1,20 € no total por um ticket integrado. O mesmo ticket, confiado a um modelo mais caro mas com critérios escritos com antecedência e uma revisão antes da integração, custa 0,90 € de tokens e passa à primeira, ou seja, 0,90 € por um ticket integrado. Neste exemplo, o modelo mais barato por token acaba por sair mais caro depois de contado o trabalho a refazer. O valor exato varia consoante a equipa e o ticket; o que não varia é a necessidade de dividir o custo acumulado pelas entregas efetivamente aceites e não pelo número de runs lançados.
O mesmo cálculo generaliza-se à escala de uma equipa: basta somar, num dado período, o custo de todos os runs de todos os tickets, e depois dividir esse total pelo número de tickets efetivamente integrados no mesmo período. Duas equipas que gastam exatamente a mesma quantia em tokens num mês podem apresentar um custo por entrega aceite muito diferente se uma integrar o dobro dos tickets da outra com o mesmo orçamento. É esta proporção, e não o total de tokens consumidos, que permite comparar honestamente dois modelos, duas equipas ou dois meses. Seguir apenas a despesa total, sem este denominador, equivale a comparar faturas sem saber o que realmente pagaram.
Esta mesma divisão aplica-se seja qual for o fornecedor de modelo escolhido: o preço de tabela publicado numa página de tarifas nunca diz, por si só, quantos runs um determinado ticket vai realmente exigir antes de ser aceite. Duas equipas que usam o mesmo modelo, à mesma tarifa, podem obter um custo por entrega aceite muito diferente consoante a clareza dos seus critérios e o rigor da sua revisão antes da integração.
Ignorar esta medida tem um custo real: segundo a CIO.com, 85 % das empresas erram em mais de 10 % na estimativa dos seus custos de IA generativa, muitas vezes porque seguem a despesa total sem a relacionar com as entregas obtidas. Na Uber, a utilização do Claude Code esgotou o orçamento de IA anual em quatro meses antes de ser imposto um limite por engenheiro, um exemplo do que acontece quando a despesa é seguida por mês em vez de por ticket.
As alavancas que mudam a fatura
Cinco alavancas atuam diretamente sobre o custo por entrega aceite, independentemente do fornecedor de modelo escolhido. Nenhuma basta sozinha: é a sua combinação que faz baixar a fatura, porque cada uma ataca uma rubrica de custo diferente das listadas acima.
Estas alavancas definem-se antes de lançar um agente, não depois: um critério acrescentado depois de a entrega estar feita não muda nada no custo já gasto. A cache de prompt, por exemplo, pressupõe que o contexto repetido se mantém idêntico de uma chamada para outra, o que favorece fichas de função estáveis em vez de reescritas a cada ticket. A escolha do modelo por função, por sua vez, pressupõe conhecer a dificuldade real de cada tarefa antes de decidir, não depois de constatado um trabalho a refazer.
Cada uma destas alavancas atua sobre uma rubrica precisa das listadas acima. A escolha do modelo por função e a cache de prompt reduzem diretamente a linha de subscrição ou API. Os critérios escritos com antecedência reduzem o tempo humano de definição, evitando idas e vindas de esclarecimento durante o run. A revisão antes da integração e as sessões retomadas em vez de relançadas reduzem a parte do orçamento que vai para o trabalho a refazer, a rubrica mais fácil de perder de vista enquanto nenhuma entrega foi ainda recusada. Seguir estas cinco alavancas ticket a ticket, em vez de as aplicar de uma vez no início do projeto, é o que permite ver qual pesa mais num projeto dado.
Estas cinco alavancas aplicam-se tanto a uma equipa pequena como a vários agentes em paralelo em vários projetos: muda apenas o número de tickets em que são verificadas a cada mês. Uma equipa que está a começar pode revê-las manualmente, ticket a ticket; uma equipa maior ganha ao segui-las num painel que liga cada alavanca a um custo por entrega aceite medido, e não estimado a posteriori.
| Alavanca | Porque reduz o custo por entrega |
|---|---|
| Escolha do modelo por função | Reservar o modelo mais capaz para tarefas com risco de trabalho a refazer, e um modelo económico para tarefas simples e bem definidas. |
| Critérios escritos antes do lançamento | Menos idas e vindas de esclarecimento durante o run, logo menos tokens gastos antes mesmo da primeira entrega. |
| Revisão antes da integração | Um erro encontrado antes de integrar custa uma revisão; encontrado depois, custa uma correção e um ciclo completo novo. |
| Sessões retomadas em vez de relançadas | Retomar uma sessão conserva o contexto já pago em tokens; relançar do zero fá-lo pagar uma segunda vez. |
| Cache de prompt | Um contexto repetido de um run para outro, como uma ficha de função estável, é faturado à tarifa reduzida da cache em vez da tarifa plena em cada chamada. |
Como a Atipol mede
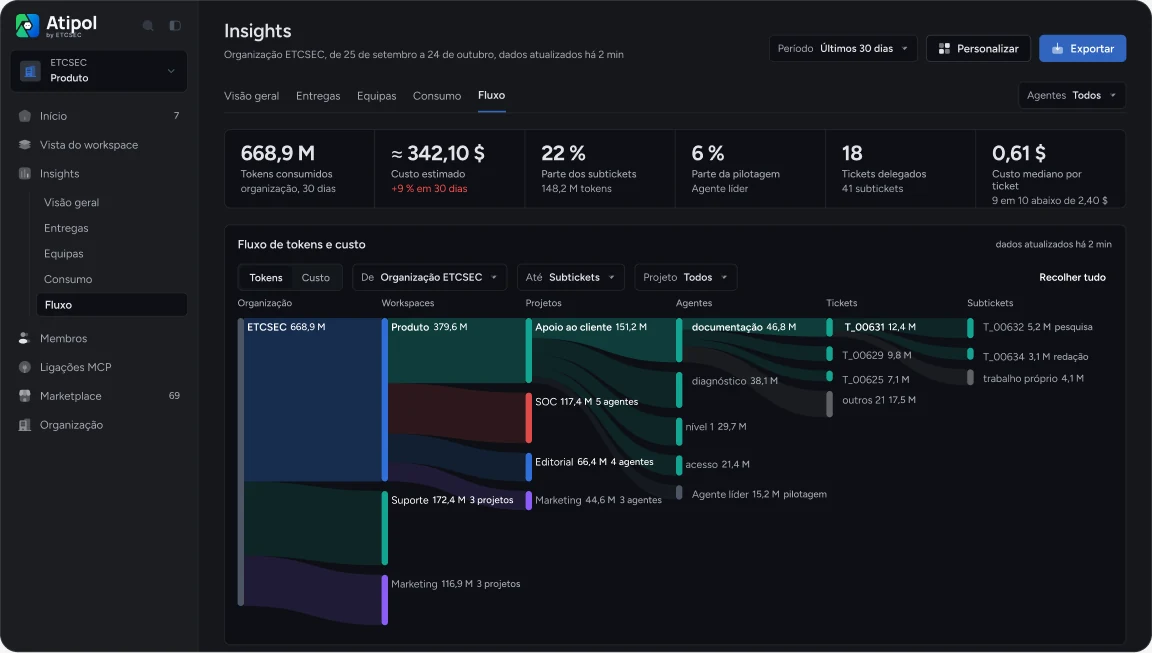
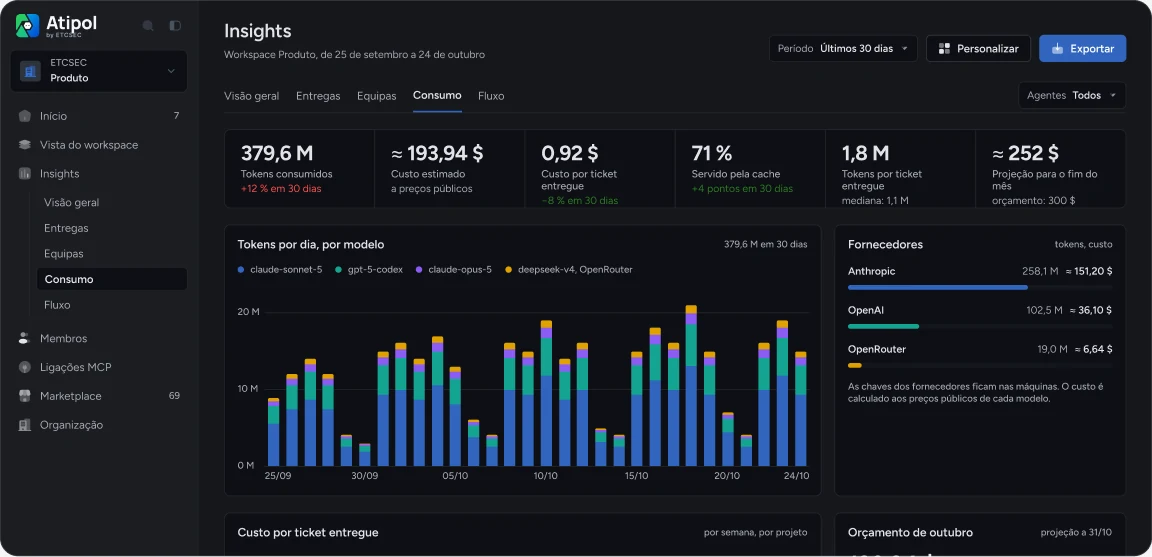
Na Atipol, o custo é seguido em tokens e em euros por run, por ticket, por agente e por modelo: vê-se exatamente que rubrica consumiu o quê, do run isolado até ao subticket, sem esperar pela fatura de fim de mês para o descobrir. Este acompanhamento aplica-se tanto a uma subscrição por utilizador, previsível para o uso diário, como a uma chave API faturada por utilização; muitas equipas combinam as duas consoante a função. Um orçamento mensal por chave de fornecedor é seguido com um alerta num limiar definido, para decidir o passo seguinte já a conhecer a despesa comprometida em vez de a descobrir depois.
Esta granularidade responde a perguntas diferentes. O custo por run diz quanto custou uma única chamada ao modelo. O custo por ticket soma todos os runs de um ticket, aceites ou recusados, e relaciona-se com o número de entregas integradas para obter o custo por entrega aceite descrito acima. O custo por agente diz qual função consome mais num dado projeto. O custo por modelo diz se o modelo escolhido para uma função continua a ser a escolha certa depois de contado o trabalho a refazer, ou se vale a pena mudá-lo para essa função em concreto. Este mesmo acompanhamento também se lê por projeto: uma organização que faz correr vários projetos em paralelo vê qual consome mais, e pode ajustar o orçamento projeto a projeto em vez de apenas ao nível global da organização.
As ofertas vão de Gratuito a Empresa sob orçamento. Pro, a 19 € com IVA incluído por utilizador e por mês, ou seja, 152 € por ano, e Business, a 39 €, acrescentam as funcionalidades pensadas para uma equipa que faz trabalhar vários agentes em vários projetos. Empresa discute-se sob orçamento para organizações com necessidades específicas, por exemplo um volume de tickets ou um número de projetos que ultrapassa as fórmulas padrão.
A Atipol não poupa tokens no seu lugar: mede a despesa, alerta quando se aproxima de um limiar definido, e exige uma confirmação explícita antes de passar para um modelo mais caro, opção que também pode proibir função a função. A decisão permanece humana e informada, não automática. Este acompanhamento por run, por ticket, por agente e por modelo é o que permite calcular, projeto após projeto, o único valor que realmente conta: o custo por entrega aceite descrito acima.
Perguntas frequentes
A Atipol faz poupar tokens?
Não é essa a sua promessa: mede a despesa em tokens e em euros por run, por ticket, por agente e por modelo, e exige uma confirmação explícita antes de passar para um modelo mais caro, opção que também pode proibir função a função. Decide conhecendo o custo, não depois da fatura.
Como seguir a despesa por fornecedor de modelo?
Com um orçamento mensal seguido por chave de fornecedor e um alerta num limiar definido, para decidir o passo seguinte já a conhecer a despesa comprometida em vez de a descobrir na fatura de fim de mês.
É preciso escolher entre subscrição e API?
Não: a subscrição por utilizador é previsível para o uso diário, a API fatura por utilização para picos pontuais, e muitas equipas combinam as duas consoante a função.
O que é o custo por entrega aceite?
É o custo acumulado de todos os runs que um ticket exigiu, dividido pelo número de tickets efetivamente integrados. É o indicador que revela se um modelo mais barato por token continua a sê-lo depois de contado o trabalho a refazer.
A cache de prompt reduz mesmo a fatura?
Sim, para um contexto que se repete de uma chamada para outra, como uma ficha de função estável: é então faturado à tarifa reduzida da cache em vez da tarifa plena em cada chamada, como confirmam as páginas de tarifas dos fornecedores de modelos.
Que ofertas da Atipol seguem estes custos?
Gratuito, Pro a 19 € com IVA incluído por utilizador e por mês (152 € por ano), Business a 39 €, e Empresa sob orçamento para organizações com necessidades específicas.
Fontes
- Claude Code, Manage costs
- CIO.com, AI cost overruns, 10/09/2025
- Outlook Business, Uber, 2026
- Anthropic (Claude), pricing
- OpenAI, API pricing
Para estimar com precisão o que isso representa para a sua equipa, utilize a nossa calculadora de custo dos agentes de IA.
Para ligar este custo a um enquadramento completo, consulte o nosso guia de governação dos agentes de IA.
A demo pública mostra uma organização fictícia em funcionamento, sem conta. O plano gratuito inclui um projeto, três agentes e um agent lead.